English translation pending — this page shows the Chinese original.
一句话结论
AnySplat用预训练几何模型同时预测场景高斯和每张照片的相机内外参,减少部署时的标定与逐场景拟合。它能处理稀疏到密集照片,但优势依赖预训练、评测相机对齐和是否后优化;主表与固定测试控制都存在不领先的条件。
输入、输出与方法
输入同一静态场景的RGB照片集合,不要求用户提供内外参;输出高斯、相机参数、深度与置信度。第一张相机固定为单位坐标系,不代表已获得世界坐标和绝对尺度真值(作者稿p.3 §3.1)。它主要是新视角合成与相机估计模型,不能直接当作在线SLAM、语义系统或高精度表面重建。
流程为:照片经DINOv2/VGGT几何Transformer,分别由深度、相机和高斯头解码;深度用预测相机反投影为像素高斯中心,外观头预测其他属性;体素内按置信度softmax加权聚合,减少重叠图元(pp.4–5 Fig2、Eq4–7)。体素尺寸是模型坐标单位,不应解释成物理米。
训练在context图像上施加渲染损失,并把VGGT相机和深度作为伪监督,再对齐网络深度与高斯渲染深度;最高置信度区域用于稳定一致性约束(p.5 Eq8–11)。因此“不用真实3D标注”仍有几何教师和预训练知识,不等于从RGB零先验学习。
评测权限先说明
为计算新视角指标,论文会把context和target图像一起用于估计target相机并做尺度对齐;重建高斯本身的入口只用context图像(p.5 camera alignment、代码src/eval_nvs.py)。这比一个只收context并立即渲染任意已知目标相机的计时入口多了计算与目标图像权限,不能混称纯context端到端延迟,也不能仅据此指控target参与高斯训练。
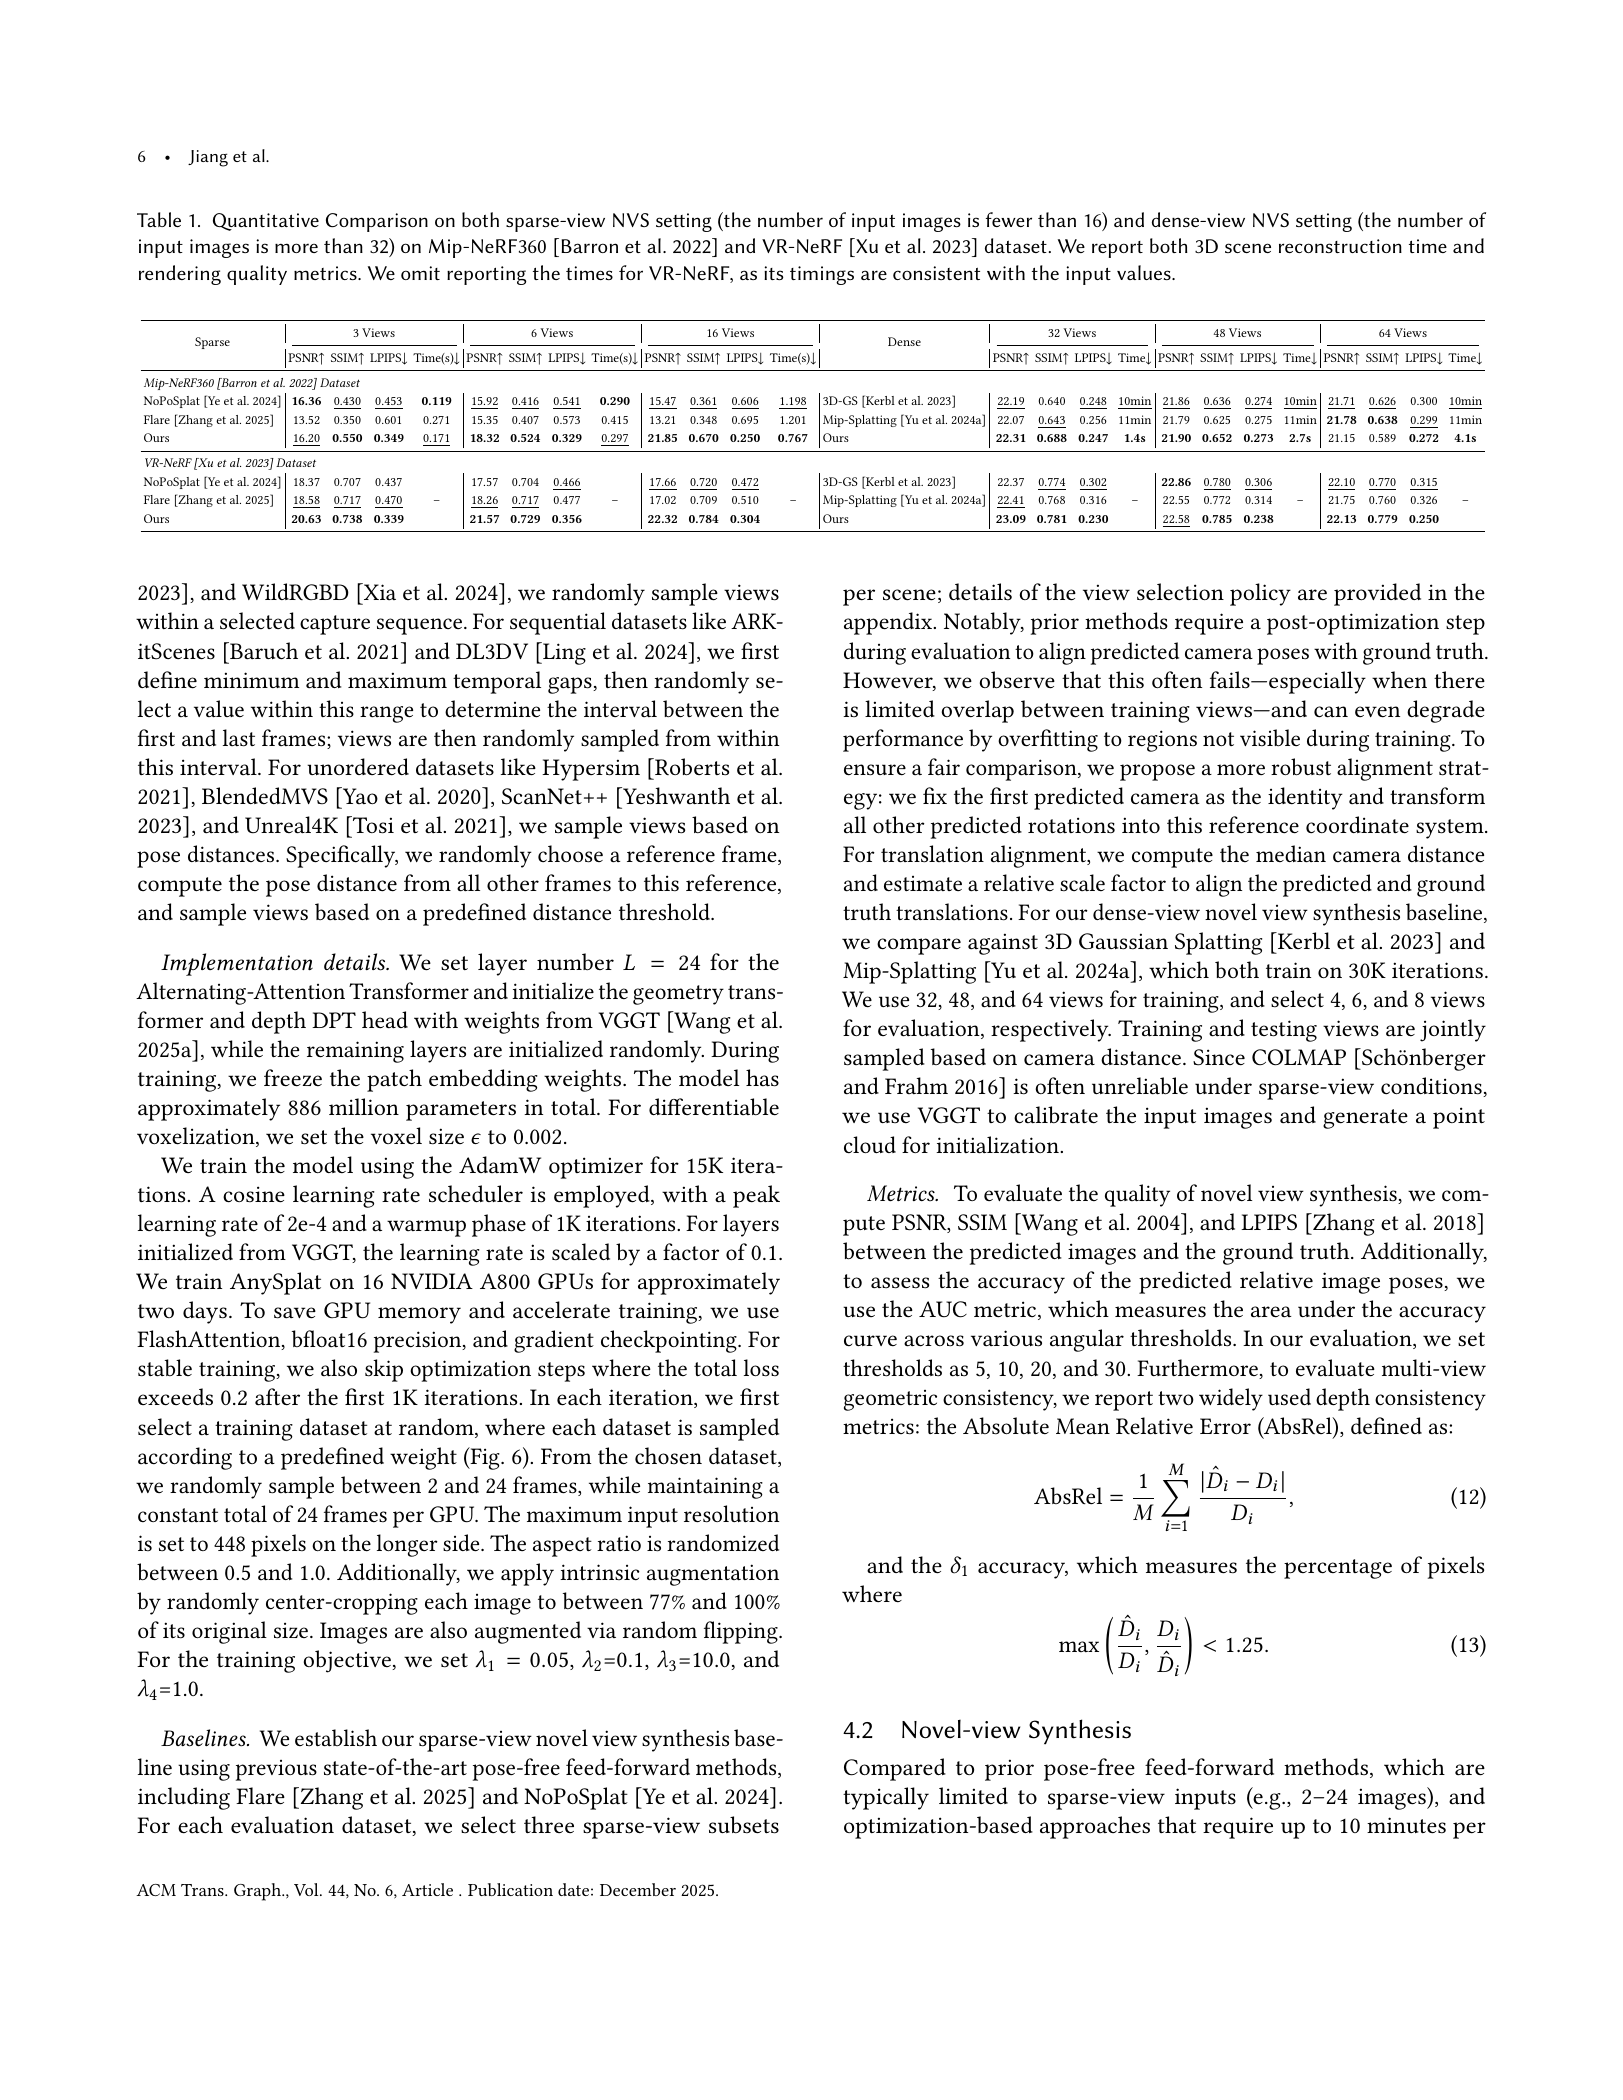
密集基线3DGS和Mip-Splatting由VGGT标定及初始化,之后逐场优化;不同于给真值相机的标准榜单。主表不同输入视数会改变测试图集合,跨列不能直接证明“照片越多越好”;附录另做固定测试图控制(pp.6、14)。
主结果:快速重建有用,但不是每项都领先
作者稿p.6 Table1,同表内部比较;时间为场景重建而非每秒渲染帧数。
| Mip-NeRF360 / 方法 | 输入视数 | PSNR ↑ | SSIM ↑ | LPIPS ↓ | 重建时间 ↓ |
|---|---|---|---|---|---|
| NoPoSplat | 3 | 16.36 | 0.430 | 0.453 | 0.119 秒 |
| AnySplat | 3 | 16.20 | 0.550 | 0.349 | 0.171 秒 |
| NoPoSplat | 16 | 15.47 | 0.361 | 0.606 | 1.198 秒 |
| AnySplat | 16 | 21.85 | 0.670 | 0.250 | 0.767 秒 |
| 3DGS(VGGT初始化) | 32 | 22.19 | 0.640 | 0.248 | 10 分钟 |
| AnySplat | 32 | 22.31 | 0.688 | 0.247 | 1.4 秒 |
| Mip-Splatting(VGGT初始化) | 64 | 21.78 | 0.638 | 0.299 | 11 分钟 |
| AnySplat | 64 | 21.15 | 0.589 | 0.272 | 4.1 秒 |
怎么读:更多context下,AnySplat比稀疏前馈基线更稳,重建比逐场拟合快;但三视PSNR略差且更慢,密集64视也会牺牲PSNR和SSIM。VR-NeRF的48视PSNR同样低于3DGS;其他指标更好不能改写成全面领先。
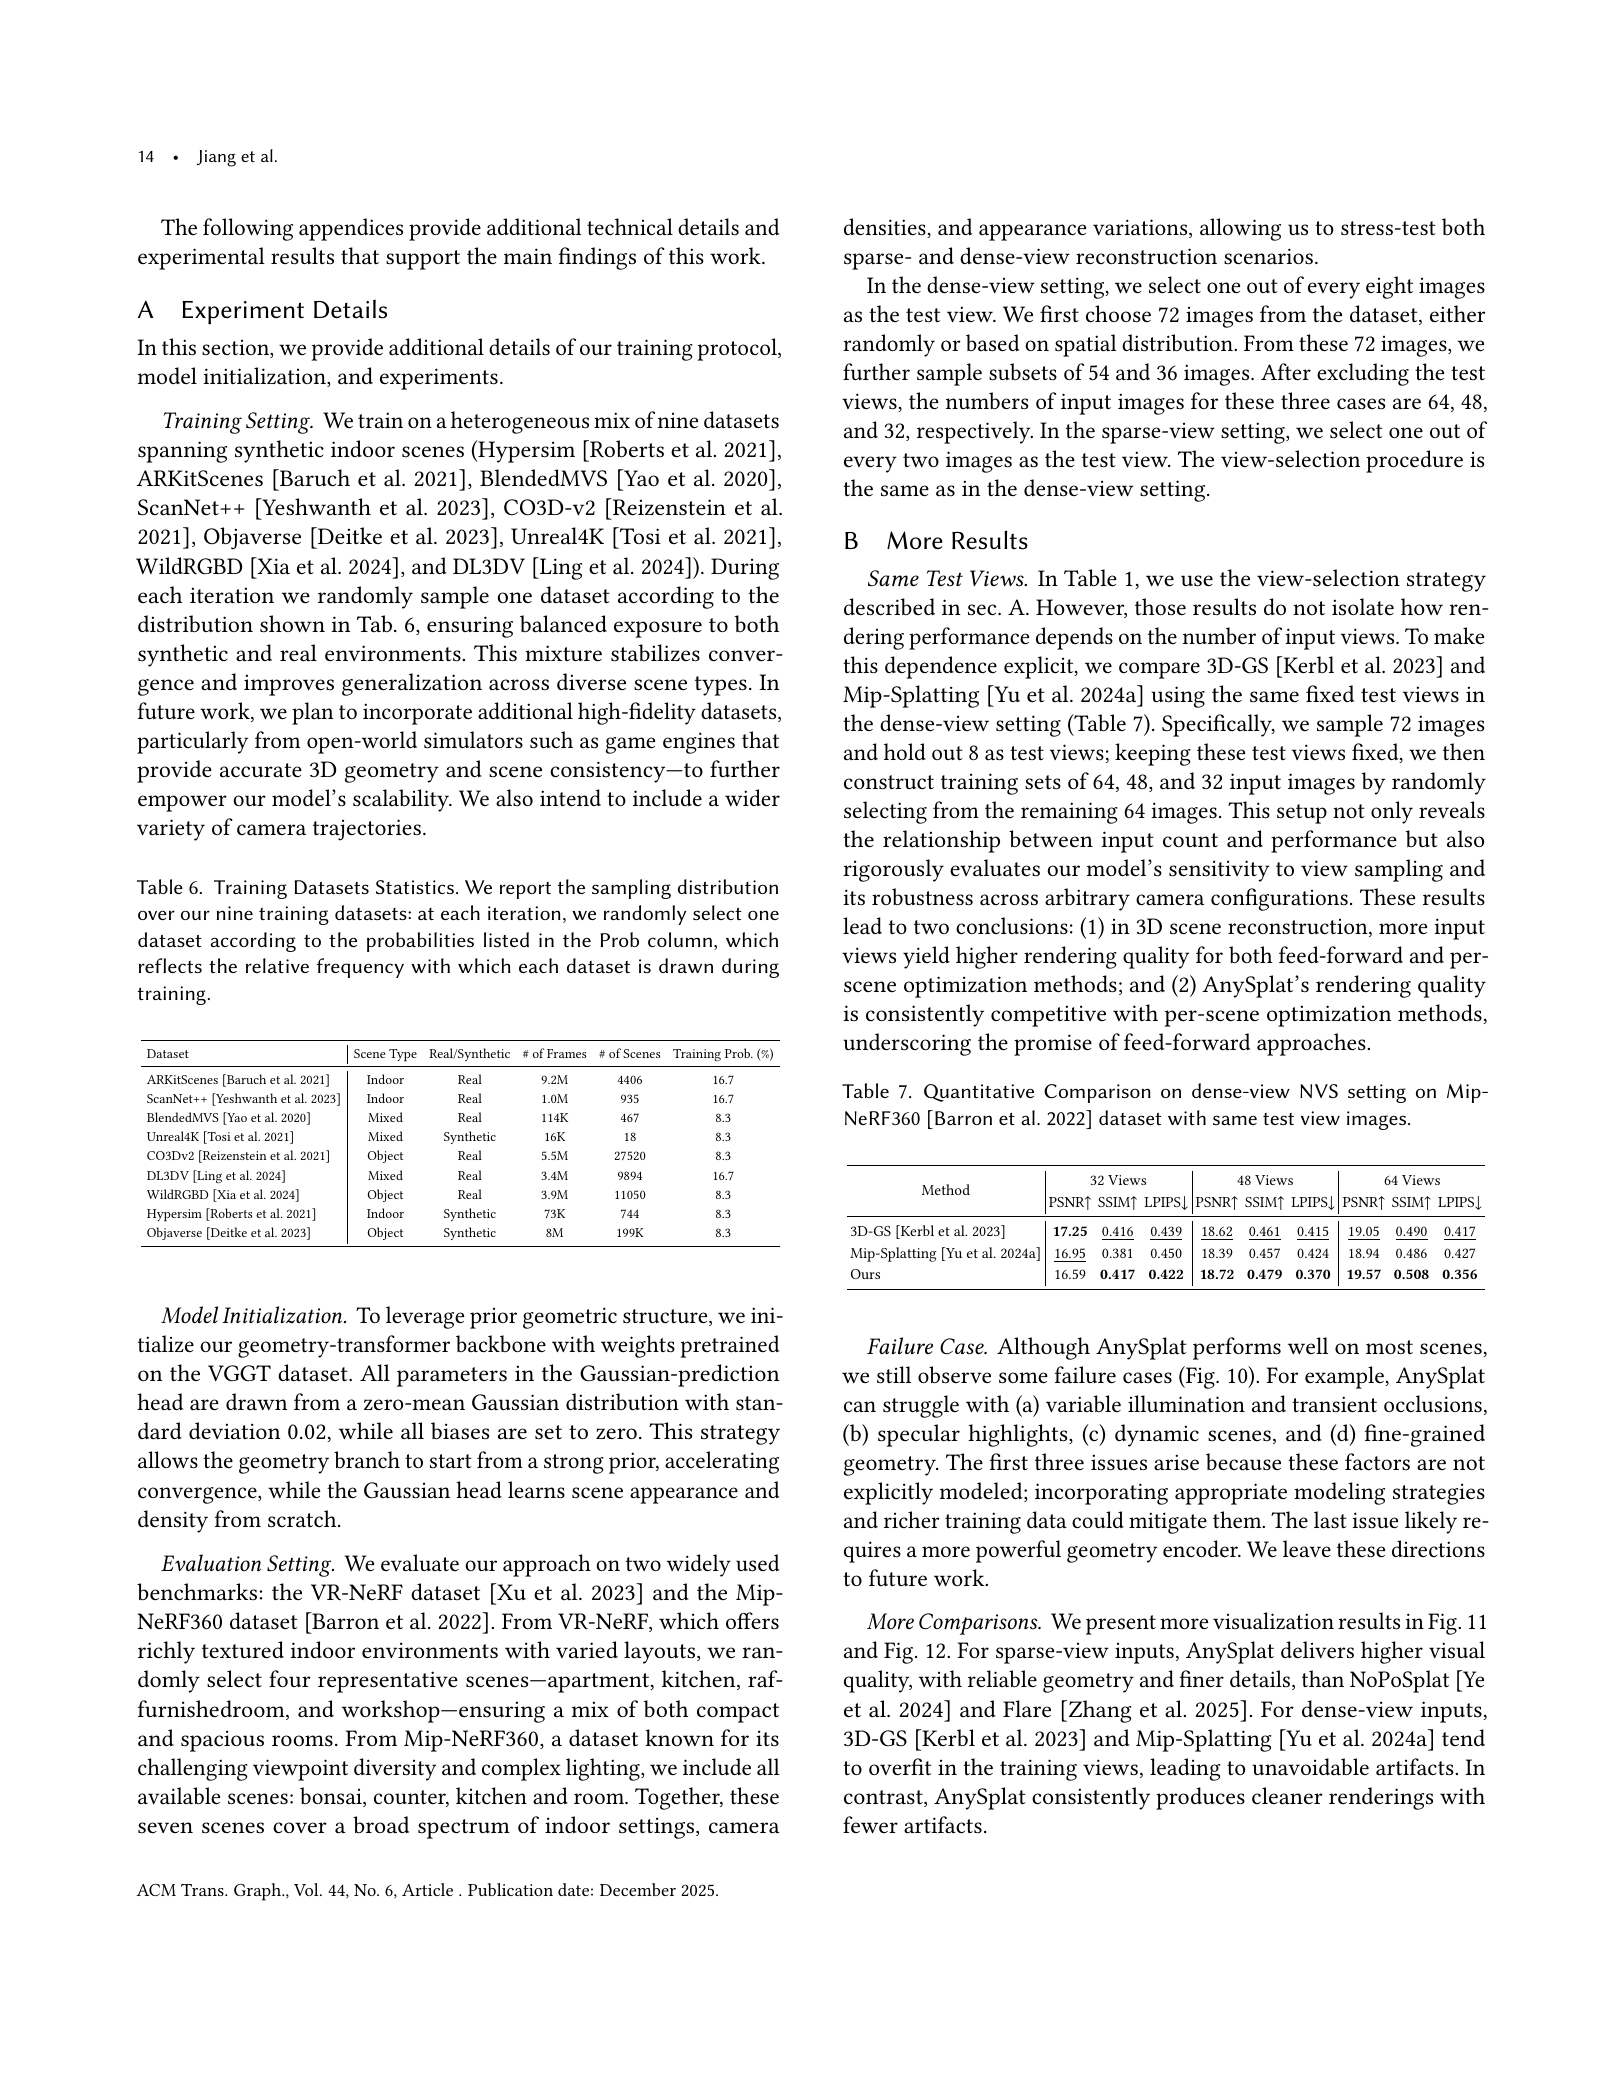
作者稿p.14 Table7固定八个测试图后,比较更清楚:
| 同一固定测试集 / 方法 | 32视 PSNR ↑ | 48视 PSNR ↑ | 64视 PSNR ↑ |
|---|---|---|---|
| 3DGS | 17.25 | 18.62 | 19.05 |
| Mip-Splatting | 16.95 | 18.39 | 18.94 |
| AnySplat | 16.59 | 18.72 | 19.57 |
AnySplat随视数增加改善,但32视仍低于两个对照。不要将该表画质与主表计时拼接成同预算结果。
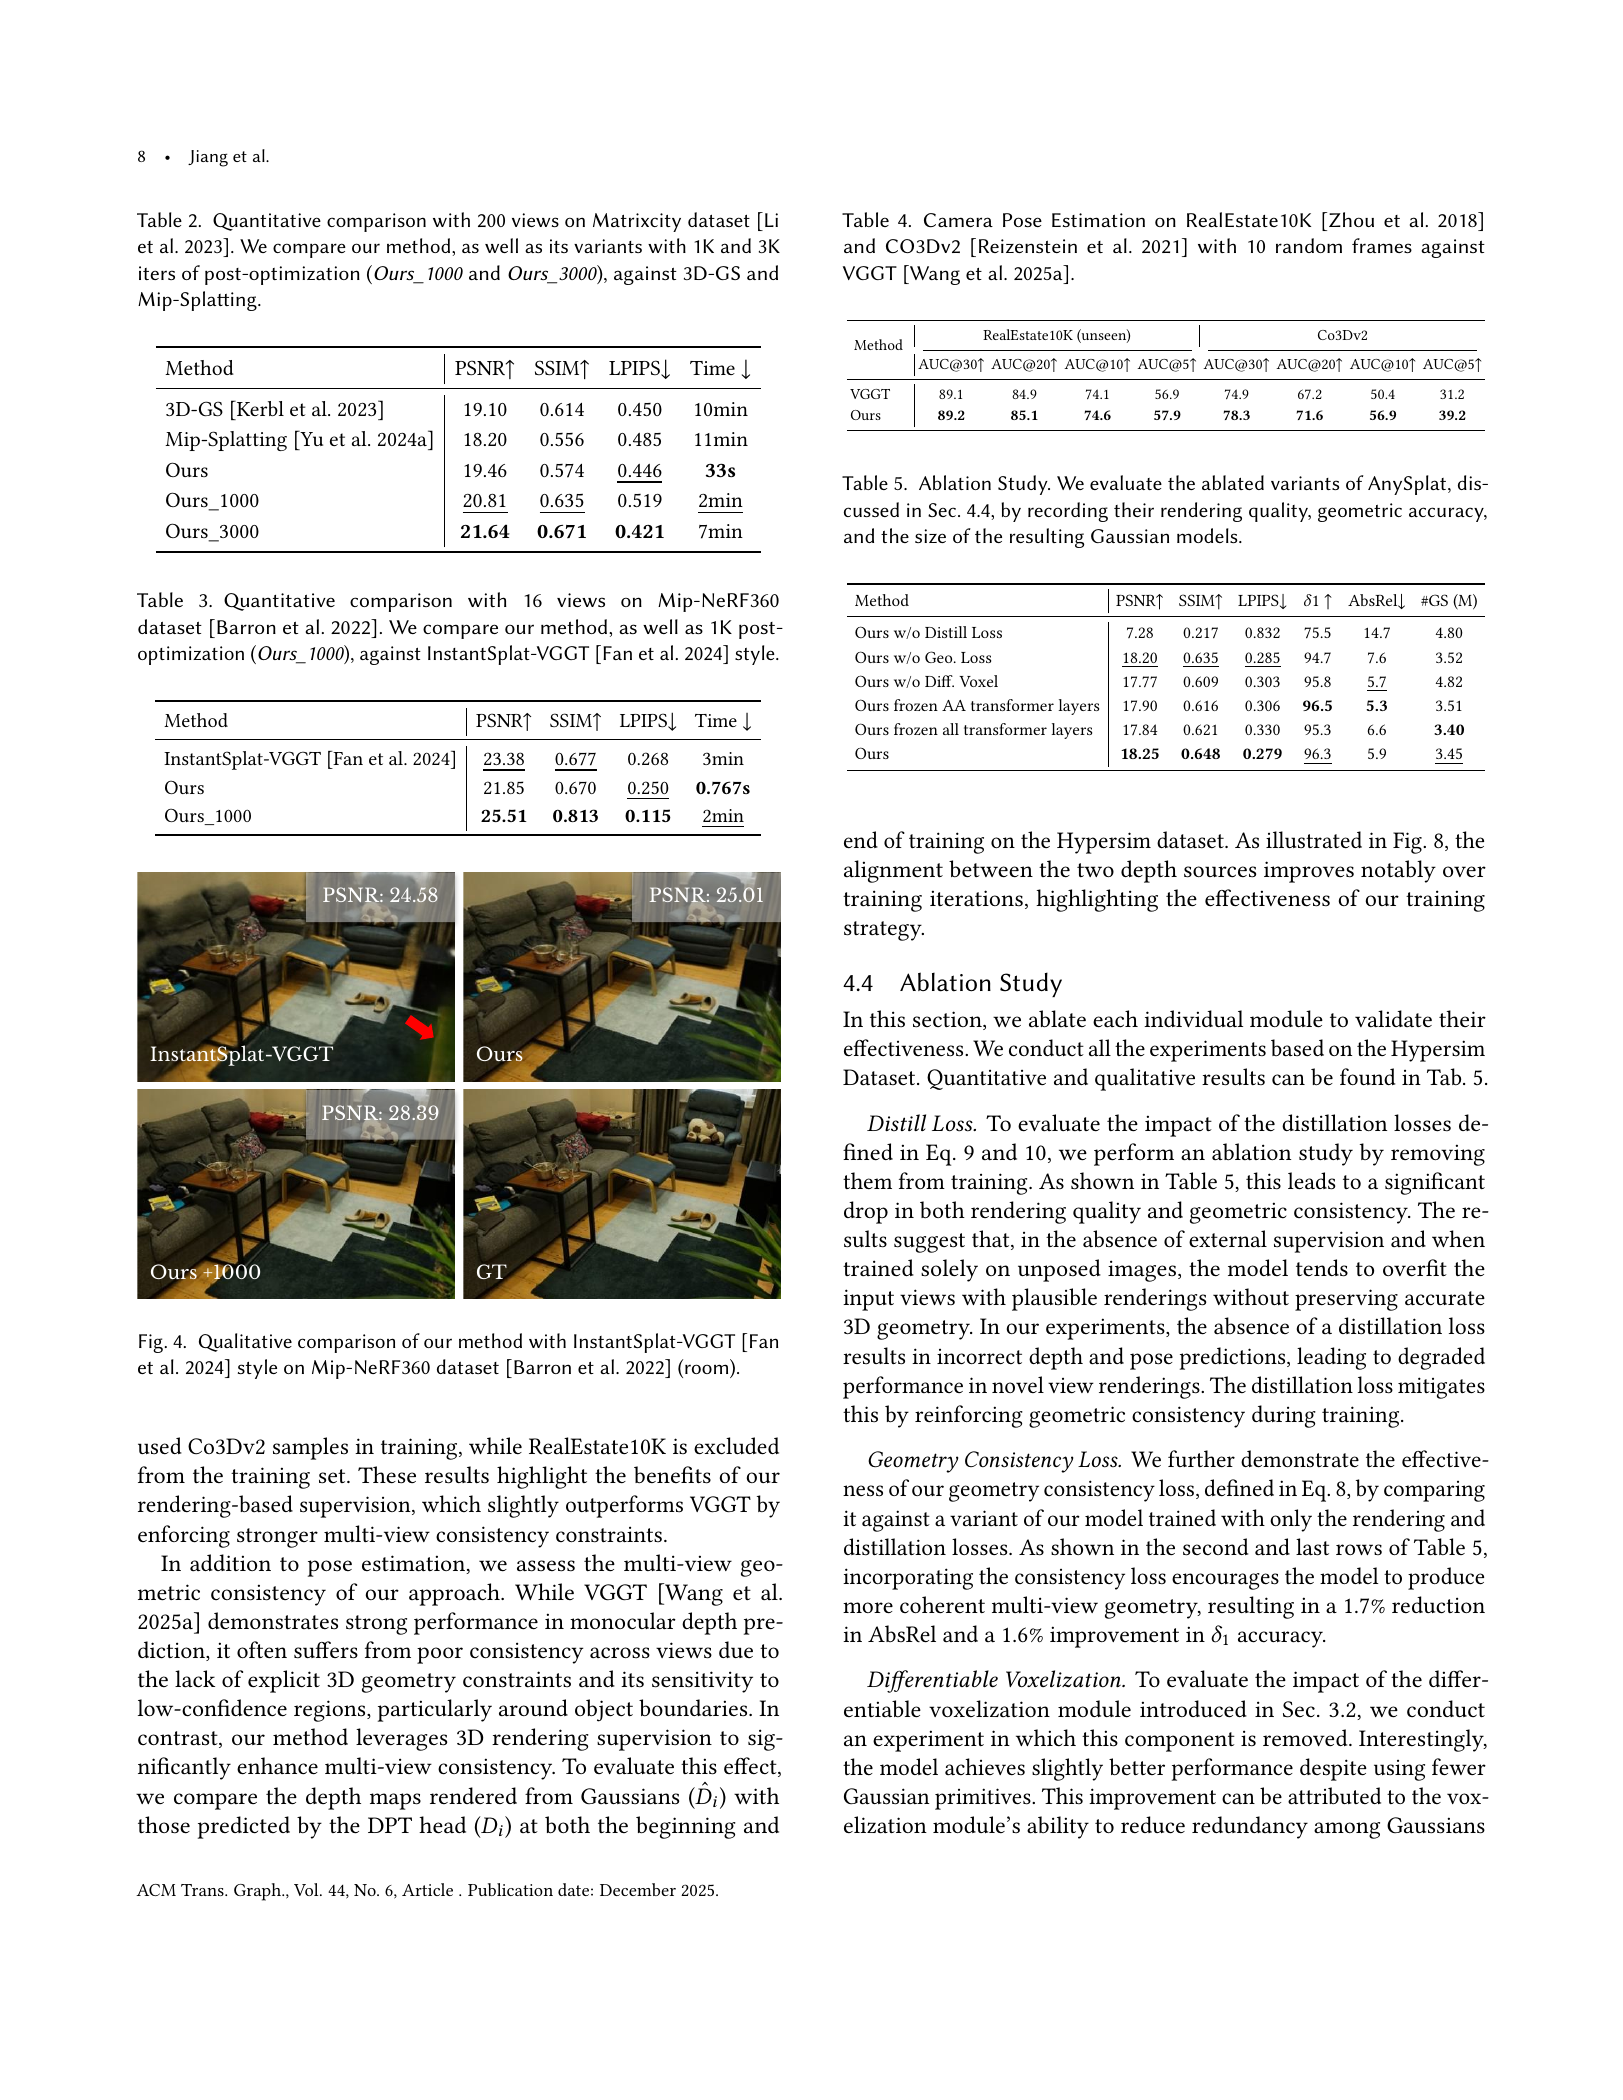
后优化必须单独计时
作者稿p.8 Tables2–3:
| 任务 / 版本 | PSNR ↑ | SSIM ↑ | LPIPS ↓ | 表中时间 ↓ |
|---|---|---|---|---|
| Matrixcity 200视 / 直接前馈 | 19.46 | 0.574 | 0.446 | 33 秒 |
| 同上 / 后优化1K步 | 20.81 | 0.635 | 0.519 | 2 分钟 |
| 同上 / 后优化3K步 | 21.64 | 0.671 | 0.421 | 7 分钟 |
| Mip360 16视 / 直接前馈 | 21.85 | 0.670 | 0.250 | 0.767 秒 |
| 同上 / 后优化1K步 | 25.51 | 0.813 | 0.115 | 2 分钟 |
| 同上 / InstantSplat-VGGT | 23.38 | 0.677 | 0.268 | 3 分钟 |
后优化会显著增加时间。Matrixcity的1K步版本虽提高PSNR,LPIPS反而退化;最快前馈时间不能配上后优化最高画质。公开计时辅助只用Python墙钟与CUDA峰值统计,未统一固定预热、同步及峰值重置;图像准备、目标相机估计和导出成本不能自动纳入该表。
消融和几何结论的限度
作者稿p.8 Table5,Hypersim;原表δ1/AbsRel显示值的比例单位未明确,避免直接解释为真实表面误差。
| 版本 | PSNR ↑ | LPIPS ↓ | δ1 ↑(原表值) | AbsRel ↓(原表值) | 高斯数 ↓ |
|---|---|---|---|---|---|
| 无蒸馏 | 7.28 | 0.832 | 75.5 | 14.7 | 4.80 M |
| 无几何一致性 | 18.20 | 0.285 | 94.7 | 7.6 | 3.52 M |
| 无可微体素 | 17.77 | 0.303 | 95.8 | 5.7 | 4.82 M |
| 冻结AA层 | 17.90 | 0.306 | 96.5 | 5.3 | 3.51 M |
| 完整 | 18.25 | 0.279 | 96.3 | 5.9 | 3.45 M |
蒸馏影响很大;体素聚合减少图元且改善图质,但AbsRel不是最优,冻结AA版本还有更好的深度指标。因此不能将图质收益直接等同真实几何全面改善。部分一致性评测比较的是自身预测深度与渲染深度(pp.8、13 Fig8),需要外部真实几何另验。
相机估计用十帧,RE10K未见集AUC@5从VGGT56.9至57.9,CO3Dv2从31.2至39.2;两方法都使用过CO3D训练,两个结果的泛化含义不同(p.8 Table4)。
数据、训练成本与版本疑点
详细设置为九库混合训练、约886M参数、15K步、16张A800约两天,VGGT初始化并冻结图像patch embedding;输入长边最高448(p.6 §4.1)。引言称8–16卡“一日内”,与此不一致,按详细设置保留边界。不把“零样本”推理解释为没有预训练成本。
附录列Mip360四个室内场景与VR-NeRF四场,却称合计七场;没有据此扩写成标准九场Mip360结论。主表与附录测试集合也不同。数据实际manifest、图像/标注包未下载,场景计数冲突未擅自修正。
Fig5 p.9的显存曲线针对渲染阶段,不能代表Transformer前馈、相机重估或后优化的全链峰值。主文未充分说明计时GPU及全部边界;没有独立GPU复现、误差条或显著性验证。
实现与许可
官方实现审计固定提交5f5e208a7dd57d52e43ea0d553a95eab526e8775。公开推理入口仅收图像、模型预测相机;评测入口另有target相机分支和对齐;后优化是独立可选流程。此处只做静态源码与配置审阅,未运行模型、下载权重或训练数据。
当前示例配置并非论文配方的逐项复现:训练步数为30K而论文写15K,两示例深度蒸馏权重也不同;teacher mask取大于0.3分位,通常保留约70%,与论文top30%不同,数据valid_mask还可覆盖该mask。体素实现先round/int/unique硬归桶,再连续加权聚合,可微性有此边界。
仓库和AnySplat权重标MIT,VGGT上游权重卡另标CC-BY-NC-4.0;不能将整个依赖链概括为MIT。作者arXiv元数据与PDF版权页分别保留,未据此扩大到所有数据或最终出版文件的再分发权。
失败与下一步
作者稿pp.14–15 Fig10记录光照变化、瞬态遮挡、反光、动态公交和自行车细杆伪影。静态前馈高斯没有显式建模这些因素,也没有证明语义分割、动态跟踪或真实表面精度。
与SPFSplat比较前要先配平内参、预训练与目标相机权限;与FreeSplatter比较要统一场景数据和后优化预算。固定测试图后,再分开测纯context预测、目标相机估计、渲染及精修的耗时和显存。若等权限优势消失,就收窄泛化和部署结论。
原始链接
相关页面
- 3D Gaussian Splatting: Representation, Optimization, Geometry, and Dynamic Scenes:无标定输入、训练先验、目标相机权限与完整成本分开。
- SPFSplat:Self-Supervised Pose-Free Gaussian Splatting from Sparse Views:不给真值外参与默认内参/预训练不同。
- NoPoSplat:Canonical-space Gaussians from Sparse Unposed Images:同篇主表中的稀疏前馈对照。