一句话结论
IVEBench把输出质量、指令服从与源视频保持分开,暴露“平滑但没改对”的问题;但Long子集的截帧/OOM排除、人评相关性的统计单位歧义,以及正式公式与公开代码差异,使其总分不能直接视为真实编辑成功率。
问题定义
输入是现有源视频+编辑指令,输出是修改后视频。评测对象不是纯文本生成,也不是剪辑元素识别或叙事理解。它试图弥补旧评测任务较窄、源素材不足、保持与服从混淆的问题;本库采用其诊断框架,不直接接受所有“全面且人类对齐”的强结论。
方法概述
数据与任务
600源片段、600提示,7个源语义维度;Short有400条32–128帧,Long有200条129–1024帧。8大类35子类涵盖风格、主体、属性、数量、主体运动、相机运动、相机角度及视觉效果(§3、附录A)。源来自Pexels、Mixkit、UltraVideo、OpenHumanVid,经自动与人工筛选;Qwen2.5-VL-72B作源描述,Doubao生成编辑/目标描述再人工修订。
600不是已证明的独立人物或原始上传数;未充分交代source/person/scene划分或各底座训练重合,污染未知。公开README提供原URL目录但说明OpenHumanVid子集缺原URL,不等于所有素材可独立追溯。
三轴十二指标
- 输出质量:主体一致性SC、背景一致性BC、闪烁TF、运动平滑MS及VTSS质量预测。多数是外观/插帧代理,不能单独证明正确运动。
- 指令服从:整体/短语语义OSC/PSC、Qwen指令满足IS、GroundingDINO数量QA。语义相似与检测器结果不能替代细粒度时序真值。
- 源视频保持:语义SF、CoTracker3轨迹MF、Qwen内容CF。MF做匹配并丢弃低相似对应,只平均剩余匹配(附录B);应另报匹配覆盖率。
代码对主体运动、相机运动与event effect省略MF,避免部分有意变化被当错误;因此MF更不能用来宣称这些任务的新动作正确。
关键发现
相同总分可能意味着不同编辑行为
表2 Short中InsV2V与Ditto总分均为0.67,但指令服从分别0.39/0.49、保持分别0.82/0.73。VACE保持0.83而指令0.25。保持得好不等于改得对;总分相同也不意味着两个系统可互换。
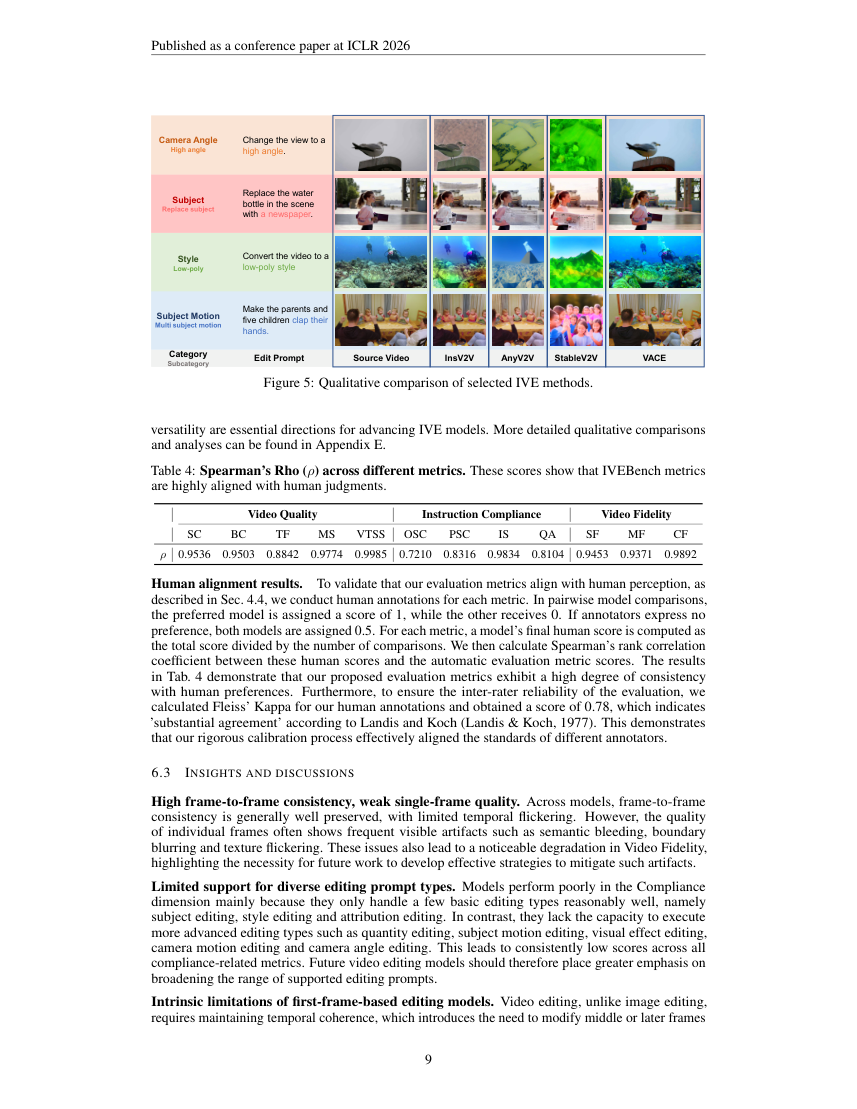
这些都是论文报告,不是本轮实验复现;只适用于文中8种方法和配置。论文图5/附录E显示语义溢出、形变、模糊和编辑不足,不能因MS较高而称复杂时序已解决。
Long排名并非完整长序列的同预算比较
附录D及表A2公开了重要限制:
| 方法 | 原文处理限制 | 对结论的影响 |
|---|---|---|
| AnyV2V | Long 200条中65条OOM,结果排除 | 失败率32.5%,仅剩135条,非全体成功率 |
| StableV2V | Long 200条中102条OOM,结果排除 | 失败率51.0%,仅剩98条 |
| VACE / ICVE | 最多81帧 | Long指源片段归属,不等于完整长度输出 |
| Omni-Video / Ditto | 最多17 / 73帧 | 不可与完整处理长片段的系统直接宣称同预算优劣 |
失败率与剩余量由本轮工具按论文分母计算。推荐同时报告全任务覆盖、失败率、实际帧数、成功条件质量,不可只显示成功样本均分。
人评存在,但高精度相关性不能直接复现
§4.4明确3模型、30源视频/指令、30参与者,逐指标成对比较且平局各0.5;§6.2报Fleiss κ=0.78,说明论文不是没有人工验证。表4报Spearman 0.7210–0.9985。
问题是§6.2把统计输入描述为“每模型每指标最终人评分”。若每指标只有3个模型均值,无ties的Spearman只有−1、−0.5、0.5、1(工具枚举),无法直接复现所报连续小数。可能另有样本级/分组计算,但公开文字未说明;不猜测真实统计单位,不把高相关性改写成独立样本级效度,也不据此指控数据造假。需原始判定、聚合键与置信区间。
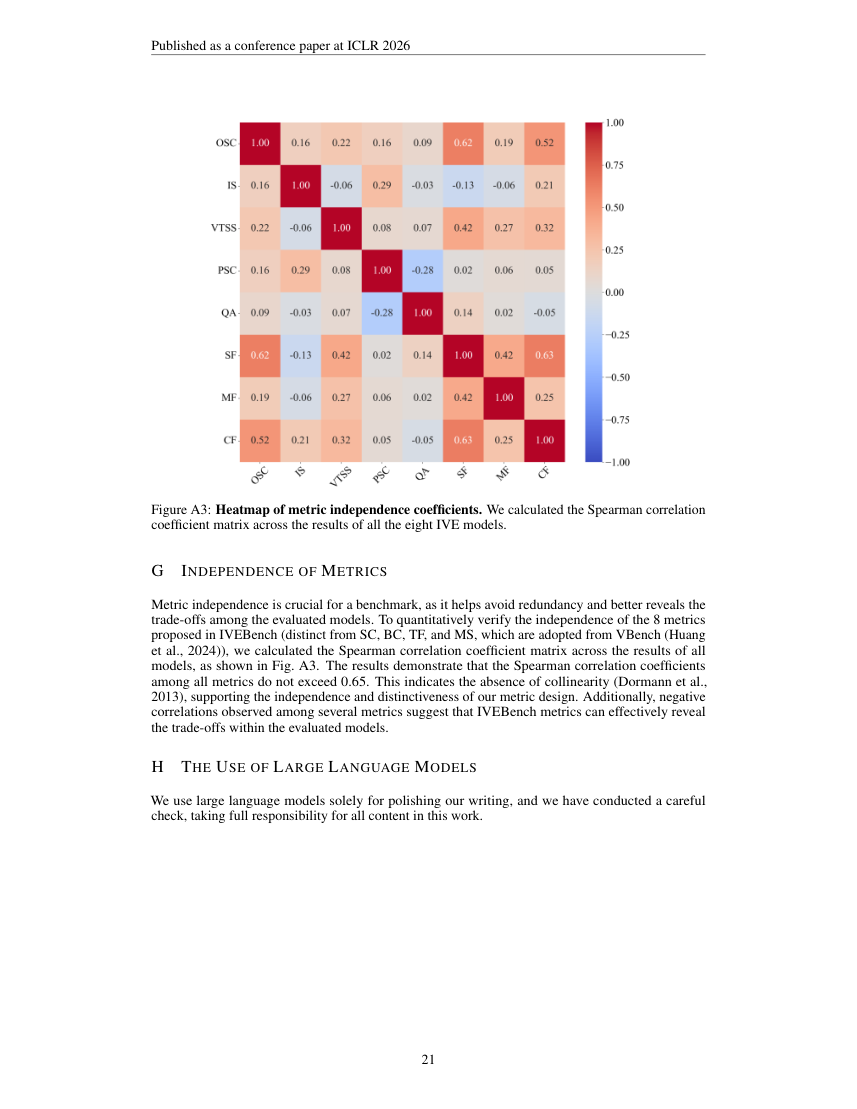
图A3非对角相关最大绝对值0.63,符合≤0.65阈值;低两两秩相关依然不证明统计独立或没有共同judge偏差。
局限或疑问
正式论文与当前代码必须分开
固定审计快照为2dcf8900ee65197f43854c76f61c66a32bb8dbfc;以下分别对照正式文本[1]、聚合代码[2]、CF[3]、MF[4]与README[5]:
- CF接口变化:正式§4.3写源描述+指令+输出视频;公开
content_fidelity.py实际给Qwen源/输出两个视频。不能把caption-only风险套到当前实现。代码还重组FPS并以约20帧采样目标和426长边压缩;未逐样本验证实际judge帧数,不能声称全程原帧检查。 - 总分权重不同:附录C中VTSS权重5,代码
get_average_score.py为4;代码另给IS/CF与VTSS尺度转换。原文不能只将表2原始数值直接加权;未经解释不把代码当作正式表格的精确复现协议。 - 公开CLI启动失败已实测:
parse_args()只返回2项,main()解包5项,运行在读取CSV之前报ValueError: not enough values to unpack (expected 5, got 2)。这是该快照入口错误,不证明论文实验未发生。保留原始代码,未修改上游或发送消息。 - 缺失分母仍关键:聚合代码将≤−1记NaN,运行失败与不适用任务需要另外区分,不能悄悄从总分消失。
成本与外推
H20实验,前三方法单卡,VACE720p双卡。表3 Short Lucy-Edit-Dev为1.52秒/帧、32.21GB、832×480;VACE为27.03秒/帧、122.18GB、1280×720。帧预算、分辨率与硬件不同,不换算统一速度比;缺完整预处理/反演/采样/VAE/I/O、评测器成本、NFE和P50/P95账本。
首帧传播对中后段事件的不足是合理机制解释,但没有专门因果消融证明唯一瓶颈。缺模型外人评、权重敏感性、失败计分敏感性、冻结/乱序负例及充分的源级污染审计。
表1使用2025,而正式venue为2026;源topics在§3为30、§5写35,勿与35编辑子类混淆。附录H“LLM仅润色”的措辞与数据/评测实际使用LLM存在冲突。代码与数据已有公开入口,不能继续沿用摘要“将开源”作为未开放结论;本轮未下载全数据或权重。
原始链接
相关页面
- 视频编辑:采用多轴验收、覆盖率与预算规则,不增加一个无条件总榜结论。
- 现有评测是否真的刻画了视频编辑理解能力:新增统计单位、judge版本和可执行聚合协议的开放缺口。
- FiVE-Bench:细粒度视频编辑评测基准:对象级编辑执行的互补坐标。
备注
全文分析及原始错误证据保存在raw/ingest/2026-09-15-ivebench/。reviewed表示已按正式文本核验并保留矛盾,不表示全部指标或论文结果已独立复现。
Sources
[1] https://proceedings.iclr.cc/paper_files/paper/2026/file/ddfe6bae7b869e819f842753009b94ad-Paper-Conference.pdf
[2] https://github.com/RyanChenYN/IVEBench/blob/2dcf8900ee65197f43854c76f61c66a32bb8dbfc/metrics/get_average_score.py
[3] https://github.com/RyanChenYN/IVEBench/blob/2dcf8900ee65197f43854c76f61c66a32bb8dbfc/metrics/fidelity/content_fidelity.py
[4] https://github.com/RyanChenYN/IVEBench/blob/2dcf8900ee65197f43854c76f61c66a32bb8dbfc/metrics/fidelity/motion_fidelity.py
[5] https://github.com/RyanChenYN/IVEBench/blob/2dcf8900ee65197f43854c76f61c66a32bb8dbfc/README.md