一句话结论
同一批生成图像在不同编码器下会得到不同的分布评分;DINOv2改善了该研究中的模型级逼真度对齐,但不能替代类内多样性、独立人评或记忆检验。
论文与证据身份
- 正式题名:*Exposing flaws of generative model evaluation metrics and their unfair treatment of diffusion models*。
- NeurIPS 2023 Main Conference Track,卷36,3732–3784页;官方日期2023-12-15,DOI已与Crossref完整题名核对。
- 本轮依据53页官方PDF及附录;作者全名按PDF保存,HTML/Crossref的简称差异保留。arXiv2306.04675v2为版本线索,不替代正式文本。
- 全文独立分析包含人评、样本量、指标定义、成本、跨表冲突及证据定位。E1为正式全文核验,不是模型复现。
问题定义
如果FID排名与人类判断不同,是生成器真的更差,还是表征空间、类内多样性或记忆诊断造成混杂?论文针对静态自然图像的无条件/类别条件生成,不直接测试文本服从、编辑保持性或视频时序。
方法概述
- 四数据集、41个模型—数据集配置:CIFAR10、ImageNet、FFHQ、LSUN-Bedroom;比较多类生成器与九个编码器。
- 编码器特征上计算FD等集合指标,FD固定50k真实/50k生成;PRDC用10k、k=5(附录B)。
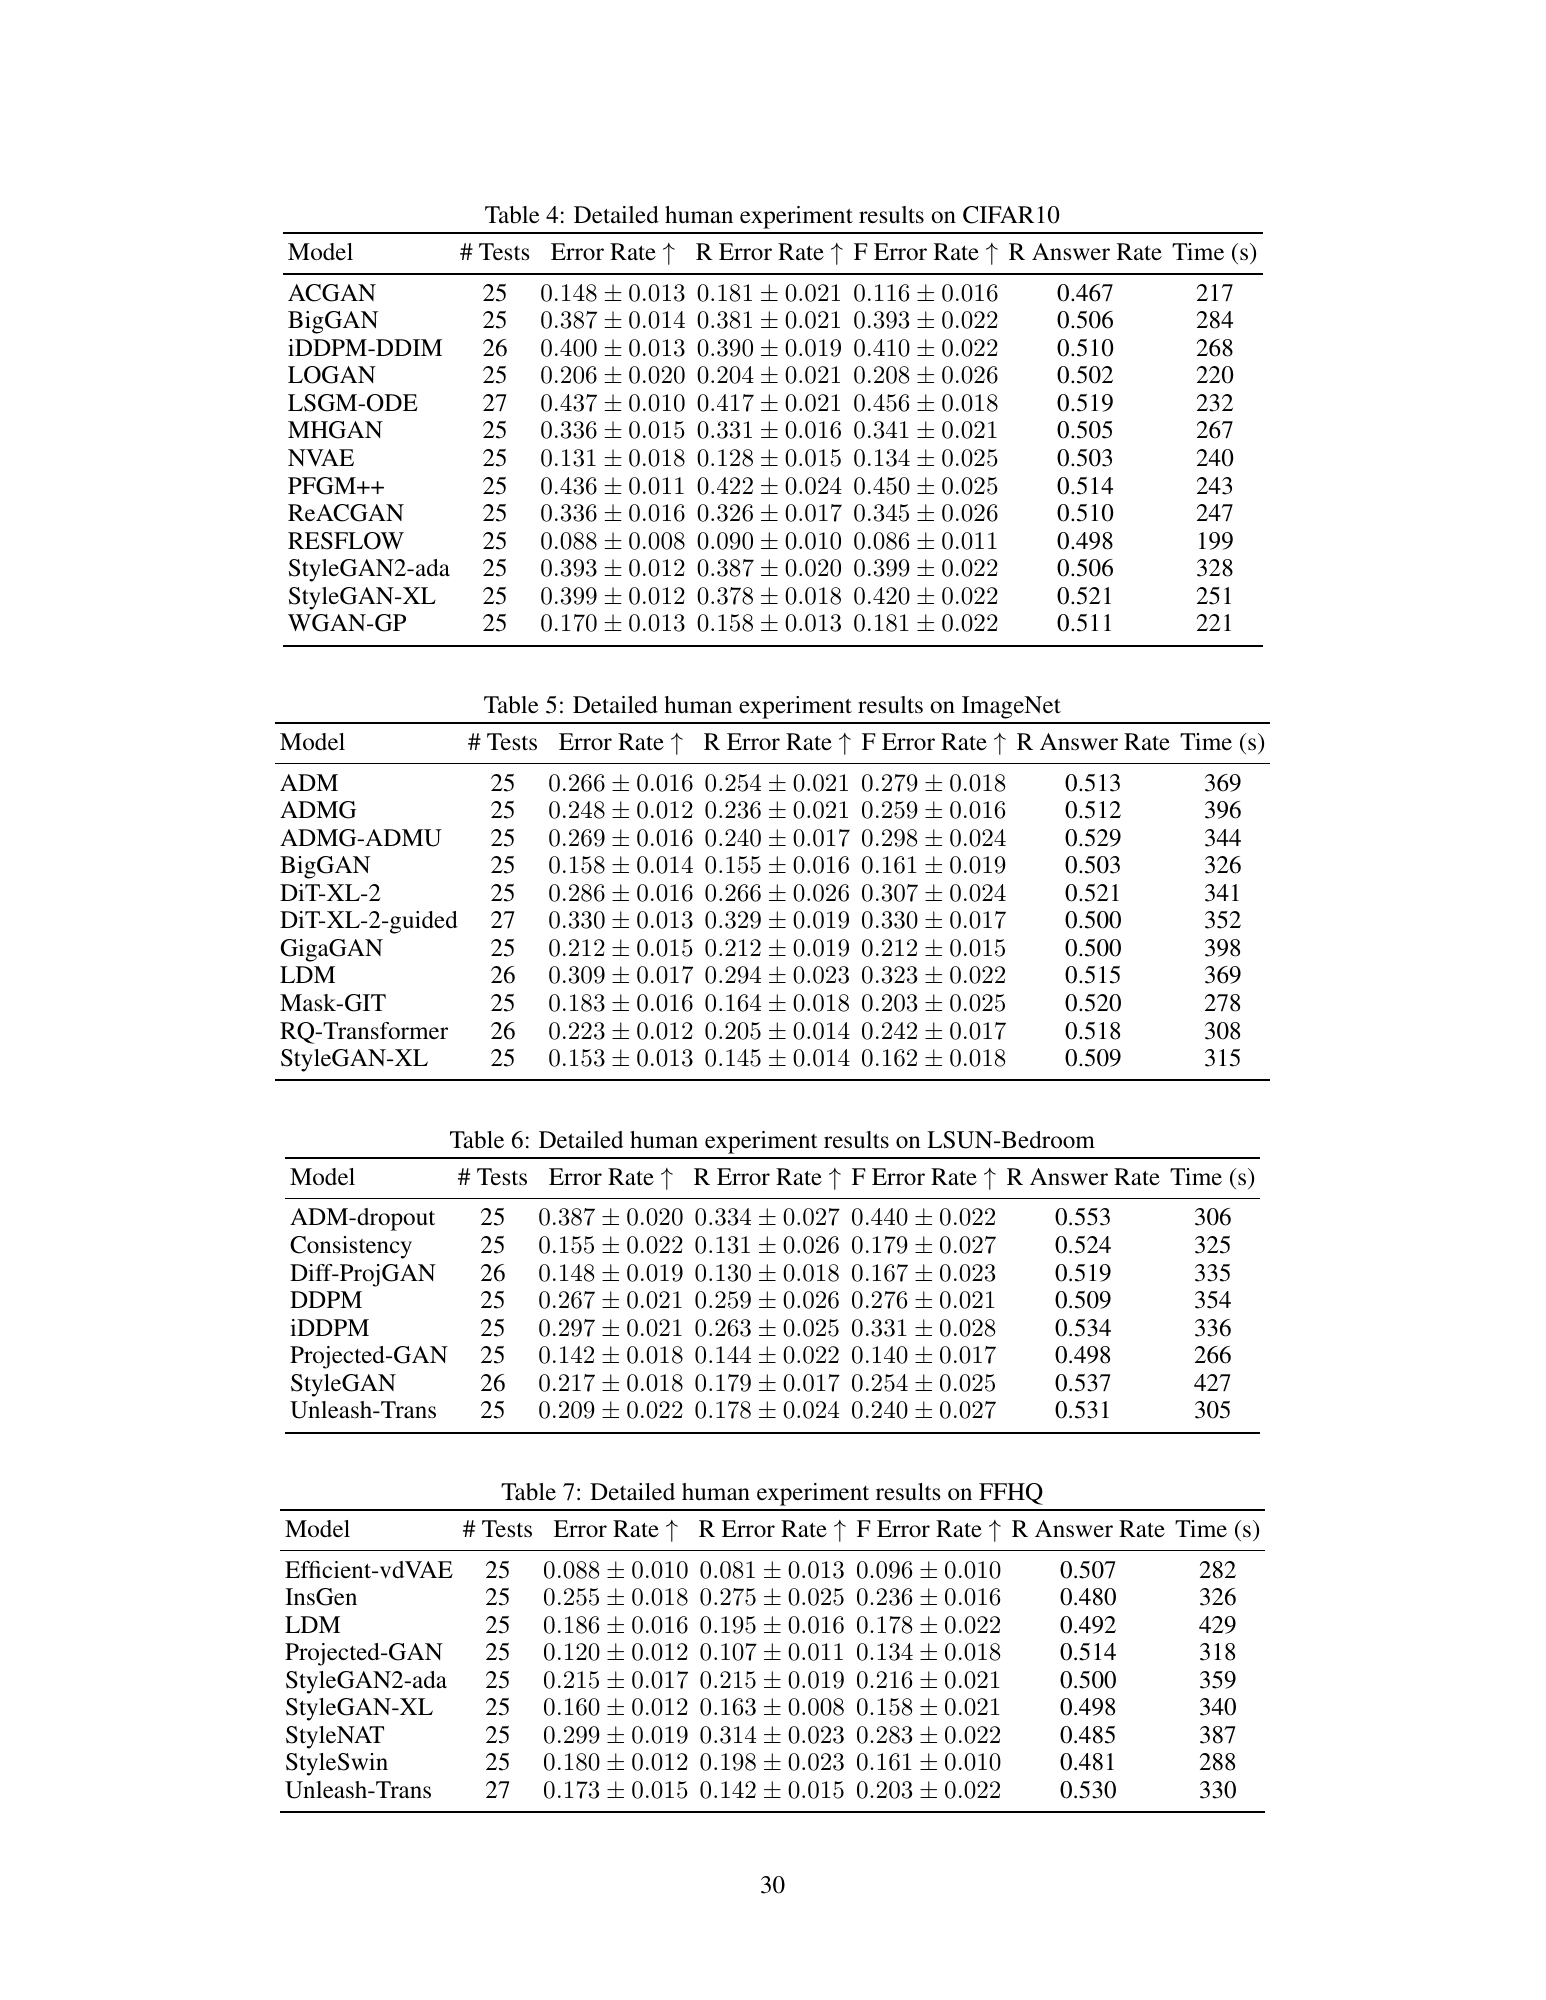
- 1036名不同参与者辨认单图真伪,每人40练习及200正式判断,真假各半、即时反馈;按参与者均值做分组统计,再与模型级指标比较(附录C)。
- 用CFG改变、类内Vendi、罕见真图、人造记忆/模式收缩与测试池替换检查替代解释(§5、附录D)。
关键发现
编码器和多样性会改变结论
- ImageNet上,DiT普通/强引导人评错误率为0.286±0.016 / 0.330±0.013;StyleGAN-XL为0.153±0.013(表5)。错误率包含真图和假图的误判,不能称为“偏好胜率”。
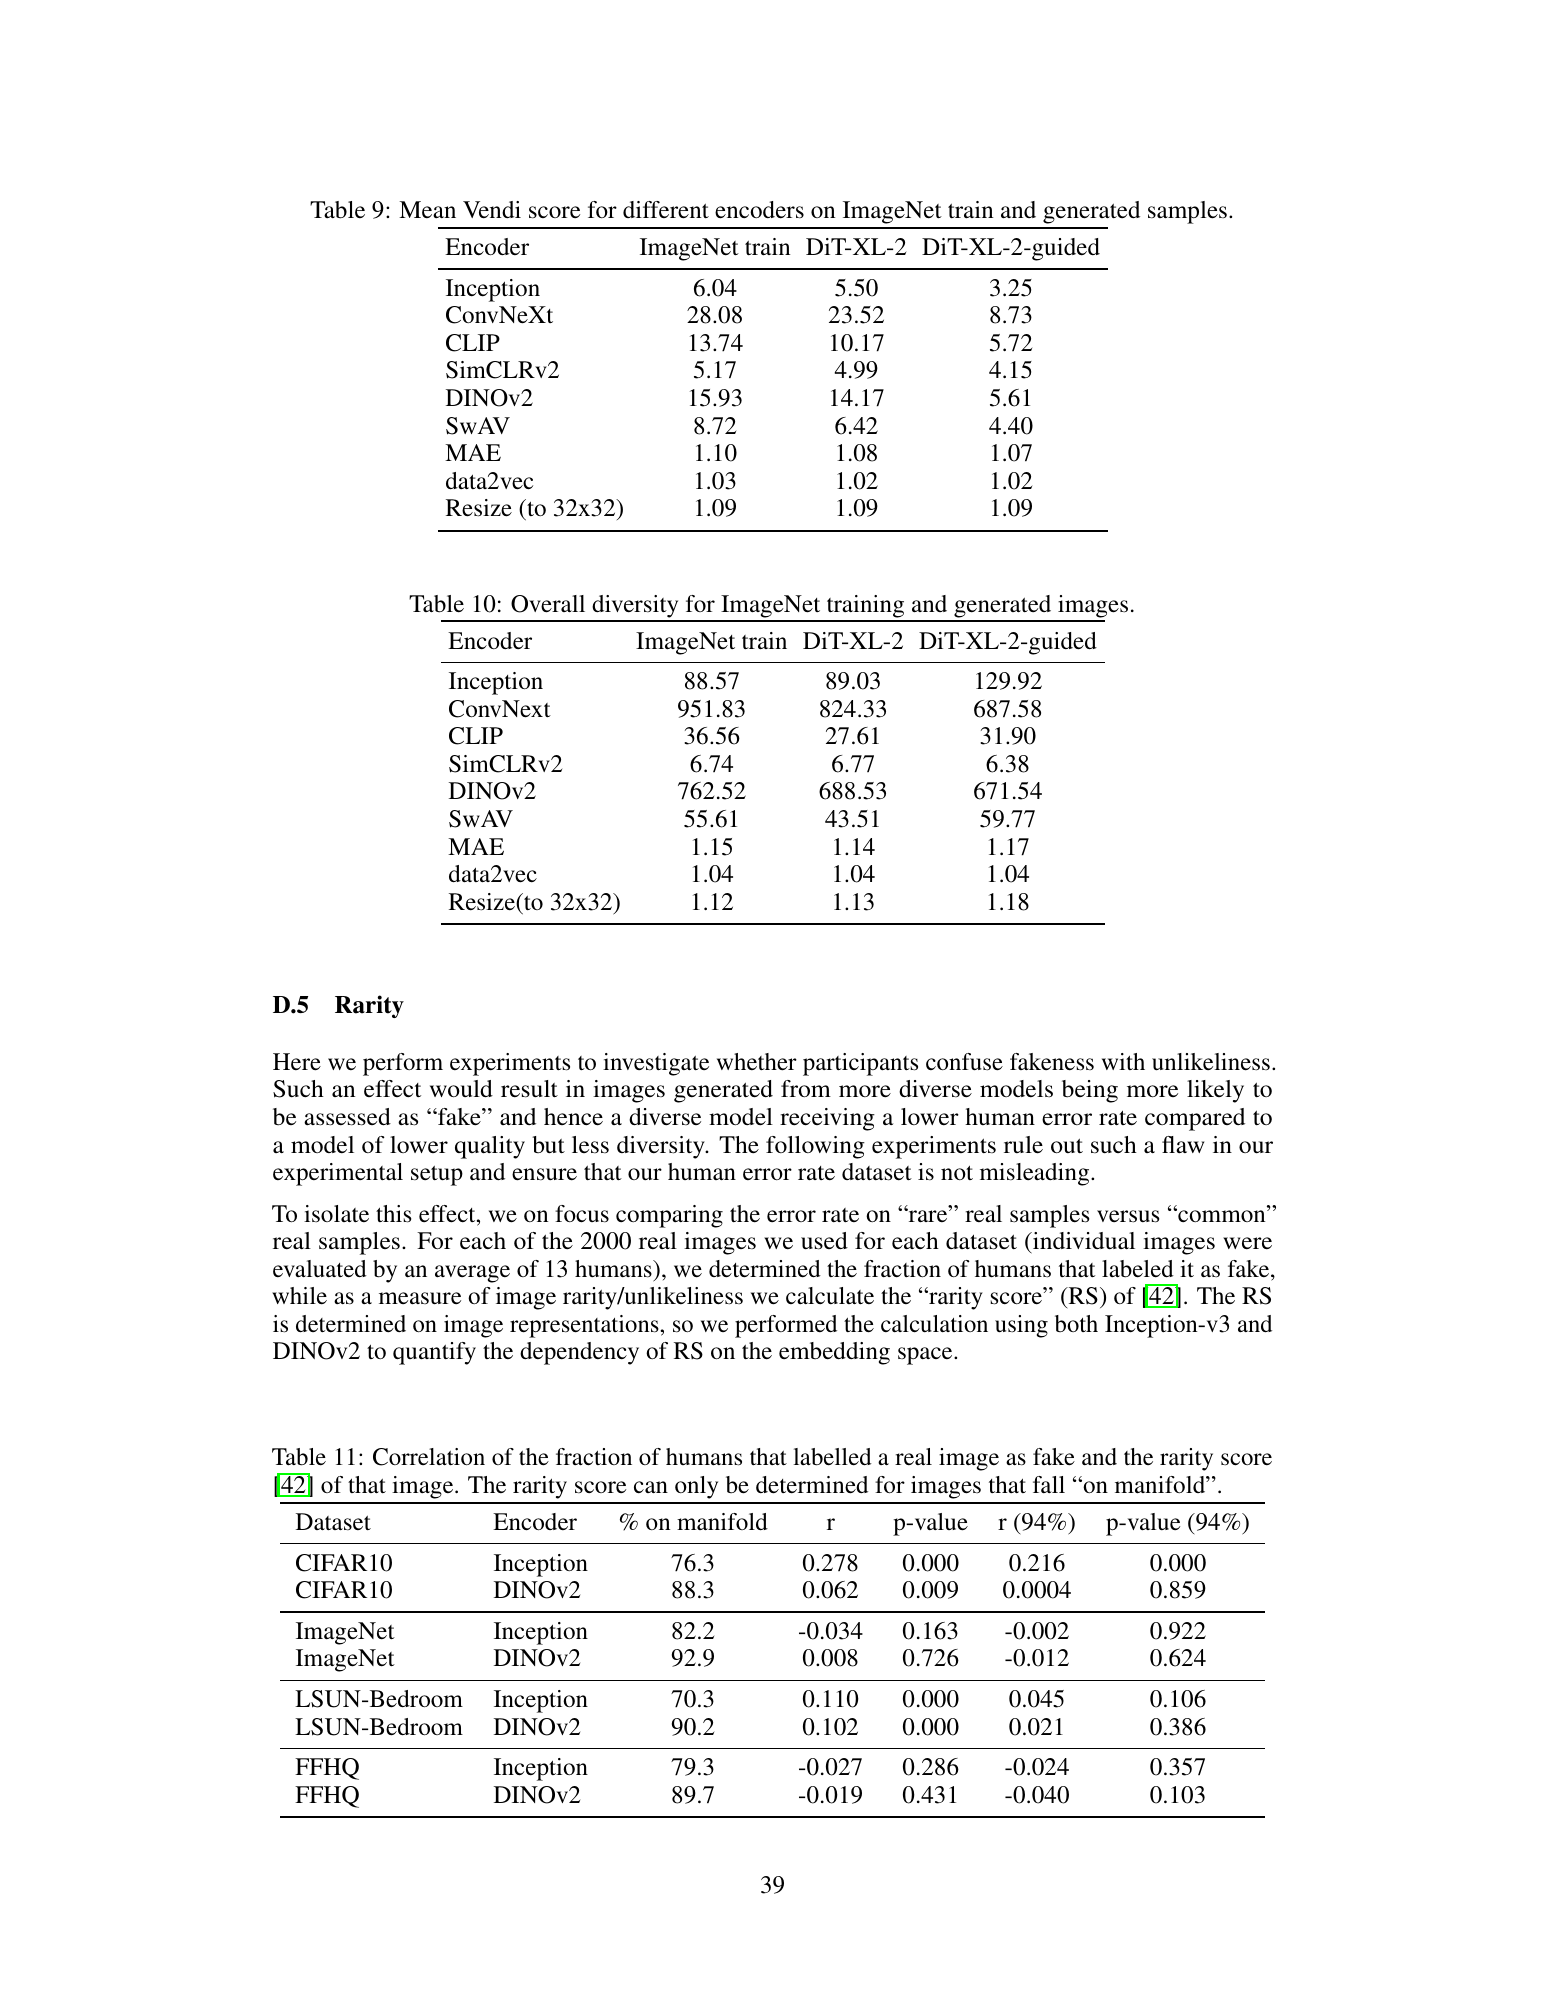
- 强引导虽更难辨真伪,类内多样性却下降:DINOv2类内Vendi14.17→5.61;Inception全局Vendi反而89.03→129.92(表9–10)。全局多样性不能替代类内覆盖。
- DINOv2 FD改善原实验的模型级相关;FFHQ家族比较并未证明扩散显著优于GAN/Transformer,CIFAR10也不是传统FID处处失败(表1、图11–12)。
- FD∞仍有有限样本偏差,ASW虽更快收敛却未更好对齐人评;不能用数学收敛性质替代测量有效性(附录D.3)。
记忆诊断需要不记忆的负对照
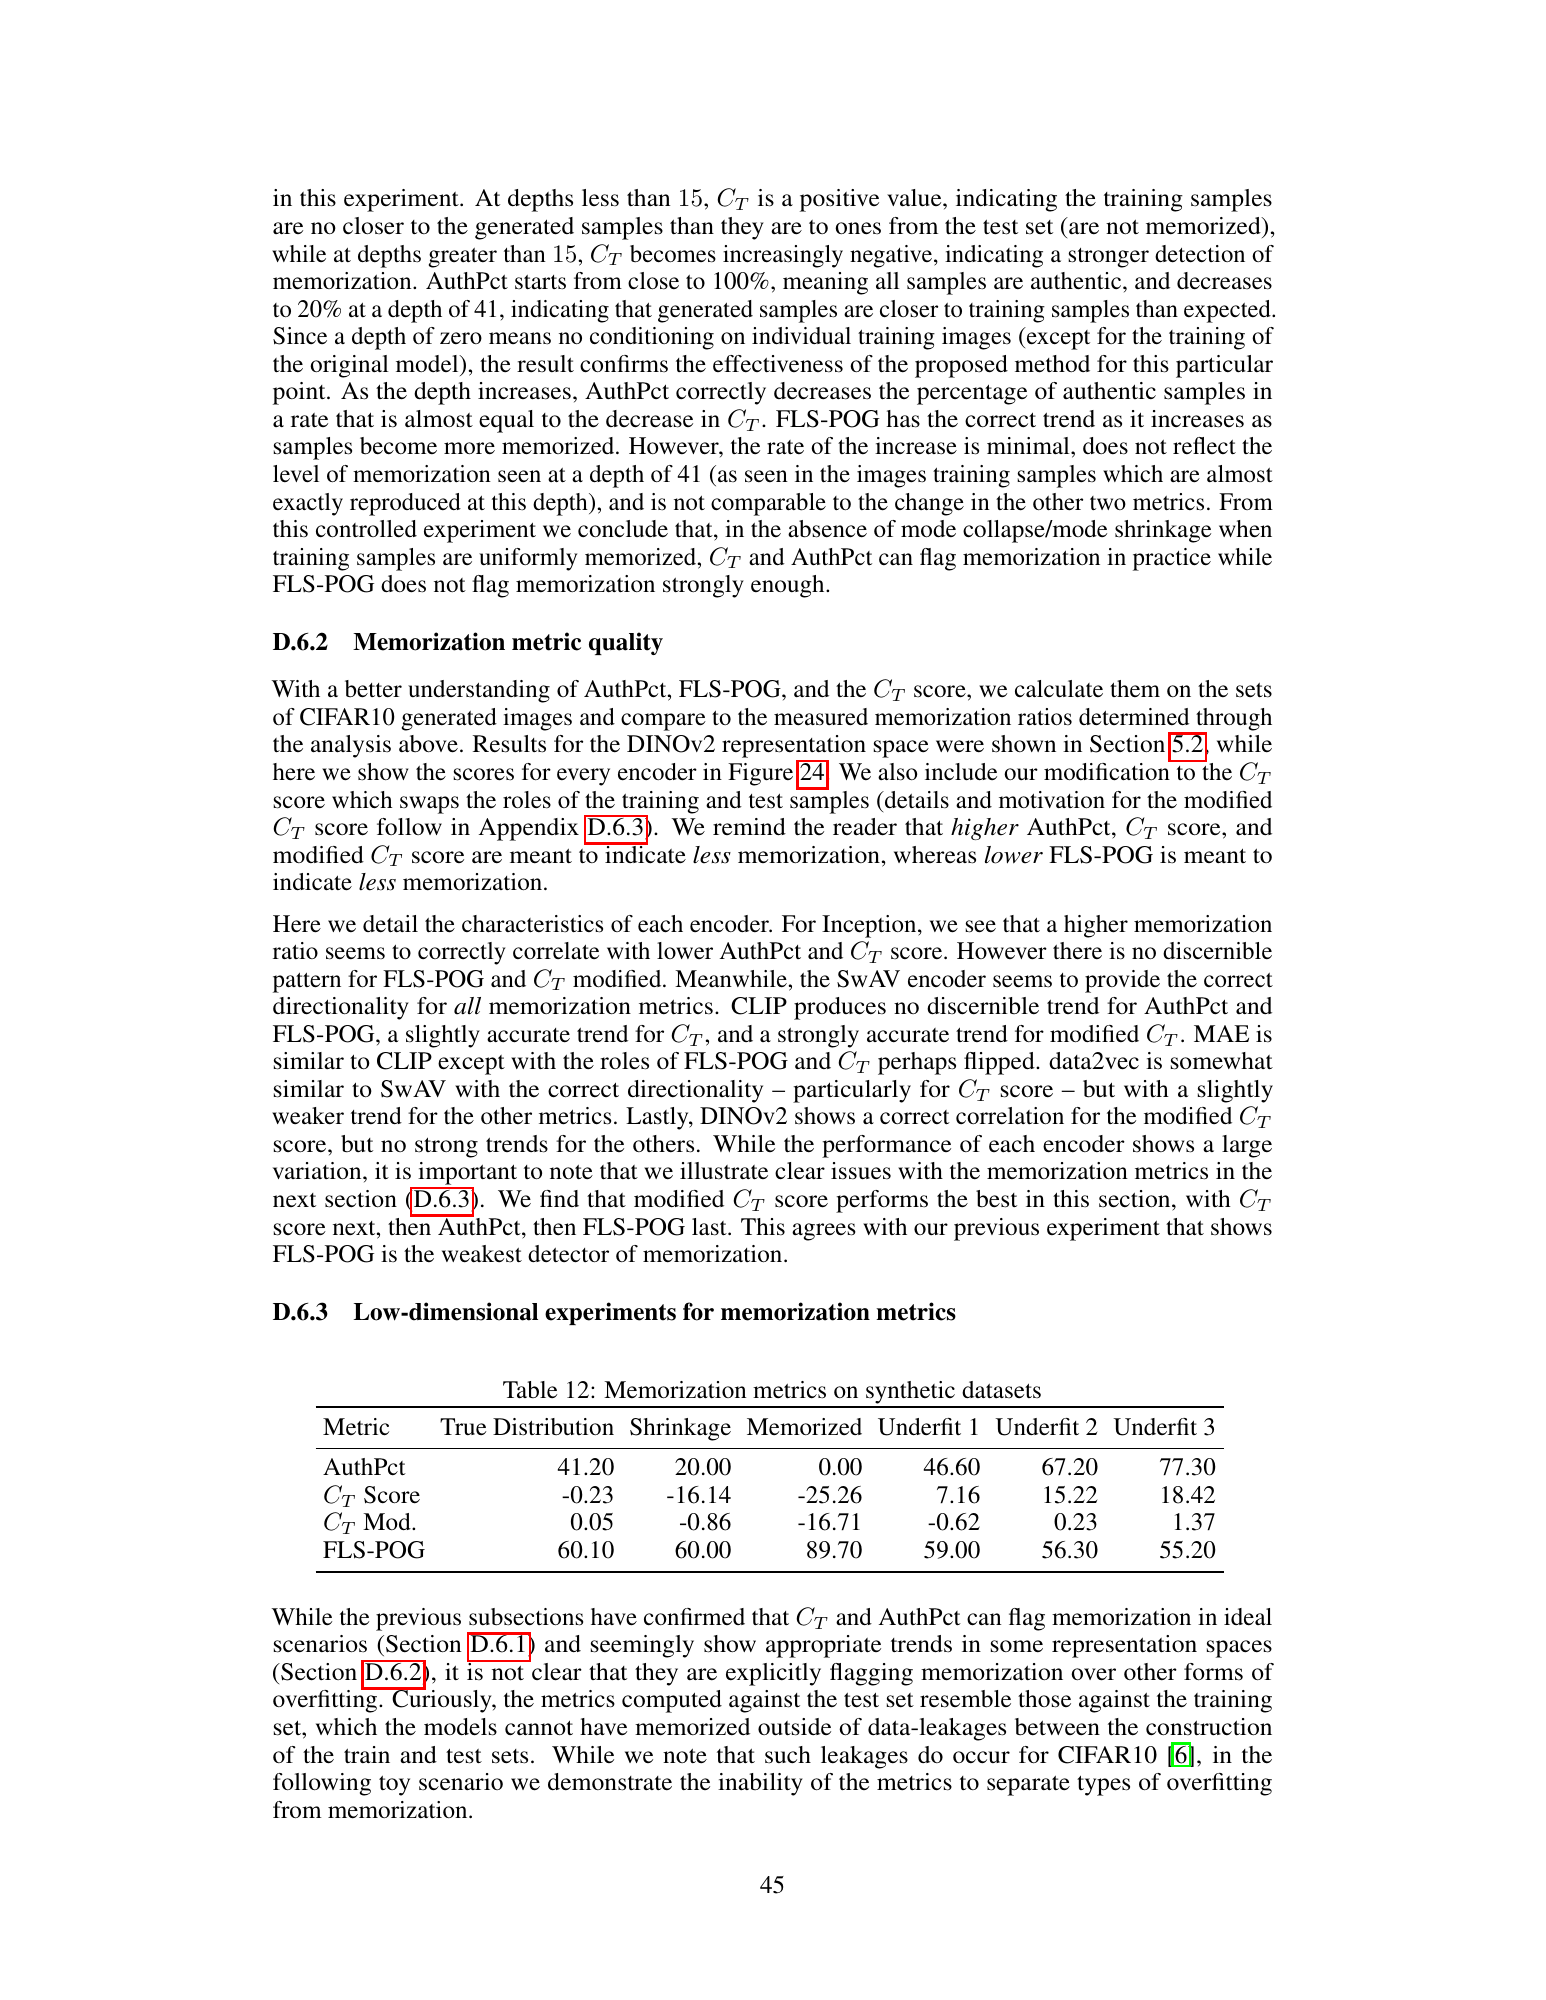
在二维合成实验中,不记忆而只模式收缩的CT为-16.14,真正复制训练点为-25.26;AuthPct对独立真分布也只有41.20%(表12)。指标下降可能来自分布几何而非复制。相反,VDVAE均匀增加重构深度的控制中CT/AuthPct确有合理趋势,不能把反例概括成“指标永远无用”。
calibrated L2需要按数据集调整近邻数和阈值,且不能排除局部copy-paste。复杂数据集未找到确凿像素复制,不等于证明模型没有记忆(§5.2、B.3、D.6)。
局限或疑问
- 统计单位:207200正式响应不是207200独立图像;FD相关性基于模型配置,真实池跨模型复用,生成图重复给不同参与者。论文有ANOVA/Bonferroni与标准误,不应说完全没有统计检验;仍需跨图像、参与者聚类和未参与编码器选择的新模型面板。
- 人评构念:有练习、即时真伪反馈、英语/教育筛选;测相对训练分布的可辨识性,不是普遍审美或任务成功。DINOv2预训练数据与评测图像的独立性没有在本文逐样本证明。
- 稀有性边界:表11只分析on-manifold图像,并报告按人评剔除6%后的结果;CIFAR10–Inception截取后仍有相关。不能将事后敏感性分析写成对所有罕见样本无偏。
- 样本量口径:主文4.1M与附录八项50k例外不一致;按例外计算3.7M,只是印文核算,尚无manifest验证。FD的统一50k比较不因此自动失效。
- 正式版本冲突:D.6.2称modified CT换训练/测试,显式公式却换训练/生成;表12 FLS-POG89.70与正文80%不同。FFHQ StyleGAN2-ada表7为0.215±0.017,表13写0.20±0.02。保留冲突,不擅自更正原始证据或推断原因。
成本与复现
论文报告图像生成约1100 GPU小时;每encoder/model组合全部指标约48单GPU小时。50k特征抽取B/L/G约4/15/85分钟,是不同成本口径。人评中位实验15分钟、中位£7.60/小时(p17、25、27);本轮未核算完整总账。
固定README版本74c79f7527fbf38fdccfbac51f25d759bc02ab07写15指标/8编码器,与论文17/9不同;只证明文档版本差异,不证明实现缺功能。本轮只核验正文、原页图像、metadata及README,并用Python核算Tests与响应数;没有GPU、完整数据集或评测器执行。
原始链接
相关页面
- 生成模型评测:把表征选择、类内多样性与记忆负对照纳入多轴验收。
- Guidance Matters:引导强度如何扭曲图像生成评测:强度匹配和NFE控制是互补证据,不把2023静态类别条件实验外推为2026文生图全面结论。
备注
下一步应冻结图像/resize/编码器与人评版本,留出新模型家族,独立测类内多样性和记忆正负控制;若收益只在选编码器面板上存在,应收窄通用替代主张。