一句话结论
LOD-GS把高斯放在可独立伸缩的三角形支撑上,再用小网络预测属性。它在本文评测场景中用更小的存储保住较多细节,但满容量画质略降,也没有证明峰值显存或真实设备运行时间更低。
先理解它要解决什么
细节层级(Level of Detail,LOD)是同一场景按预算保留不同程度的细节。这里调的是模型存储与高斯采样量,并非相机距离分辨率抗混叠。输入为已知相机的静态多视角RGB;COLMAP稀疏点或均匀点可作初始化,不能据此称为无相机输入或前馈重建(主p.4 §4.2、p.6 §5.1)。
三角汤(triangle soup)是彼此不必连成网格的三角形集合。每个三角形内部用重心坐标定位高斯,顶点特征插值得到局部特征,小型多层感知机(MLP)结合观察方向预测颜色、透明度、尺度和旋转。高斯另有位置偏移,因此不是严格贴在三角平面上的几何表面(主pp.4–5 Eq3–8)。
方法:先确定支撑,再学习局部细节
- 阶段1优化三角顶点及其高斯属性,内部位置/透明度插值;按透明度、尺度和位置梯度增删三角,使支撑覆盖物体区域。损失为图像L1、结构相似性与尺度正则(主pp.4–5 §4.2)。
- 阶段2固定三角支撑,学习顶点特征、视角依赖triangle-MLP及局部偏移,继续增删内部高斯并加体积mask(主p.5 §4.3)。
- 用不同抽样间隔保留内部高斯形成各LOD;间隔为2的幂,密度估计用于高/低密度区域的75%/25%采样配比(主p.6 §4.4、Fig6)。
三角支撑减少需要保存的特征和显式球谐外观参数。它与Matryoshka的有序前缀训练机制不同,也不能代替Mip-Splatting对采样频率的约束。
主结果:存储下降,满容量画质仍有取舍
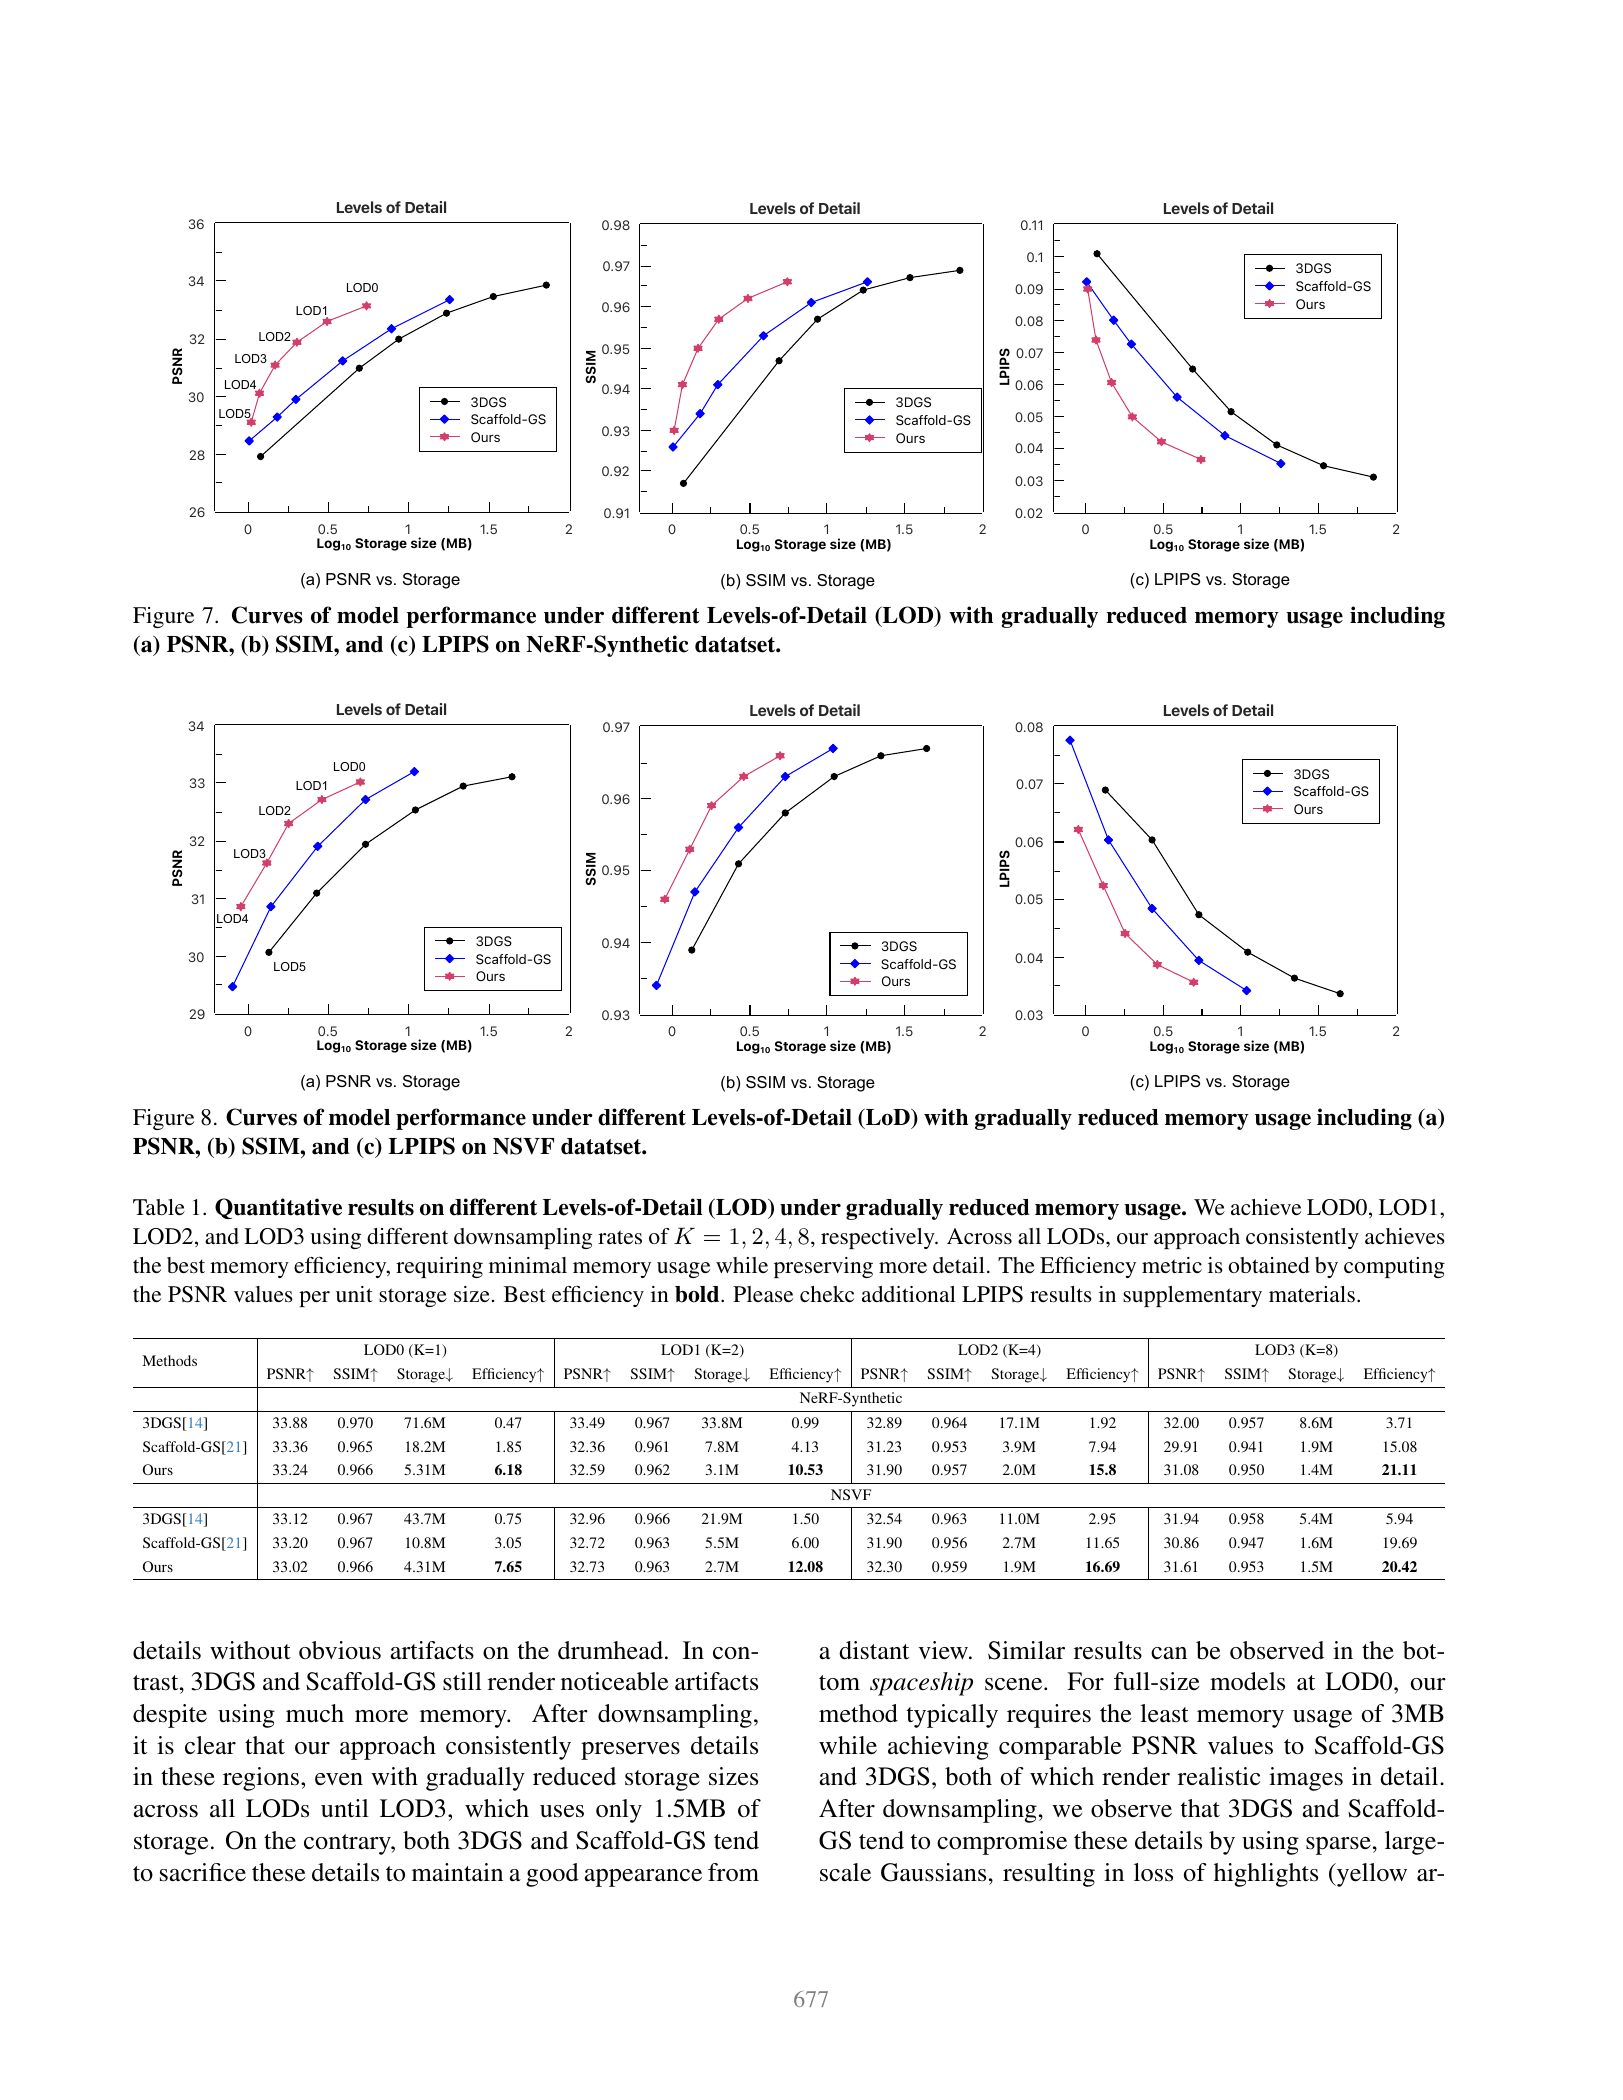
主p.7/proceedings677 Table1;同一数据集、同一表内部比较。LOD编号代表抽样间隔,不代表各方法用了相同存储。
| 数据集 / 方法 | LOD0 PSNR ↑ | LOD0 SSIM ↑ | LOD0 存储 ↓ | LOD3 PSNR ↑ | LOD3 SSIM ↑ | LOD3 存储 ↓ |
|---|---|---|---|---|---|---|
| NeRF-Synthetic / 3DGS | 33.88 | 0.970 | 71.6 MB | 32.00 | 0.957 | 8.6 MB |
| NeRF-Synthetic / Scaffold-GS | 33.36 | 0.965 | 18.2 MB | 29.91 | 0.941 | 1.9 MB |
| NeRF-Synthetic / LOD-GS | 33.24 | 0.966 | 5.31 MB | 31.08 | 0.950 | 1.4 MB |
| NSVF / 3DGS | 33.12 | 0.967 | 43.7 MB | 31.94 | 0.958 | 5.4 MB |
| NSVF / Scaffold-GS | 33.20 | 0.967 | 10.8 MB | 30.86 | 0.947 | 1.6 MB |
| NSVF / LOD-GS | 33.02 | 0.966 | 4.31 MB | 31.61 | 0.953 | 1.5 MB |
NeRF-Synthetic有八场景、NSVF选四场景(主p.6 §5.1)。怎么读:满容量LOD-GS比Scaffold小很多,PSNR略低;缩到LOD3后,LOD-GS又能用较少存储获得更高PSNR。原始3DGS同LOD的PSNR仍高,但存储也更大。不能将这一表写成所有画质指标全面领先。
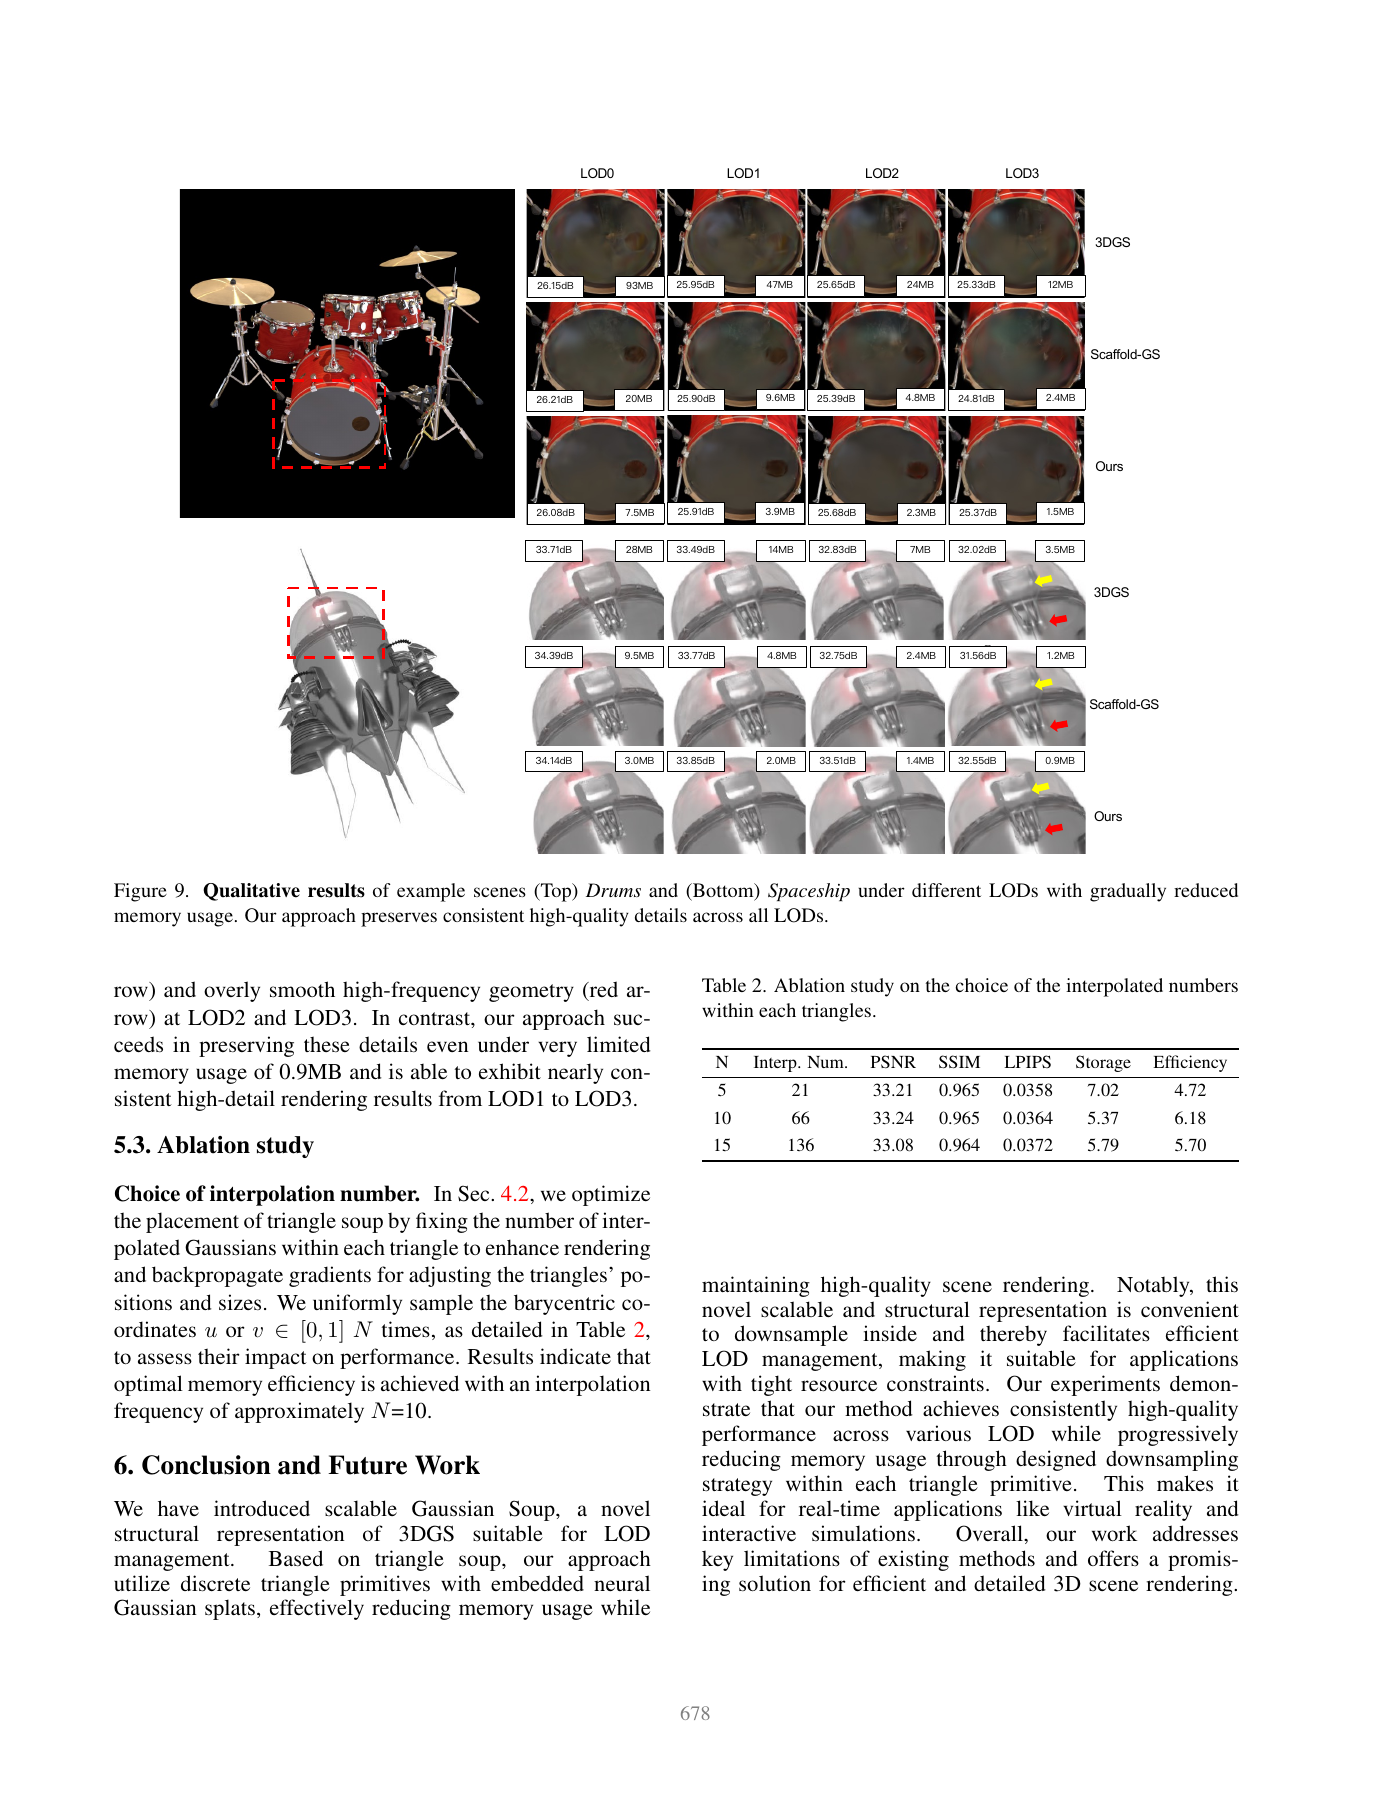
作者另报Efficiency=PSNR/存储,反映其质量—存储取舍,不是FPS、峰值显存或码率。Fig7/8横轴是log10存储MB;Table1没有逐LOD LPIPS数值,不能从曲线杜撰精确数字。Drums和Spaceship的Fig9只作定性例子,不证明真实几何准确或所有场景无伪影。
消融:默认插值数有效,但感知指标不一致
主p.8/proceedings678 Table2;N是重心坐标采样频率,插值数为每三角内部高斯数。
| N | 插值数 | PSNR ↑ | SSIM ↑ | LPIPS ↓ | 存储 ↓(沿用原表数值) | 作者Efficiency ↑ |
|---|---|---|---|---|---|---|
| 5 | 21 | 33.21 | 0.965 | 0.0358 | 7.02 | 4.72 |
| 10 | 66 | 33.24 | 0.965 | 0.0364 | 5.37 | 6.18 |
| 15 | 136 | 33.08 | 0.964 | 0.0372 | 5.79 | 5.70 |
N10的存储效率最好,但N5的LPIPS更好。该表默认项的存储5.37、SSIM0.965与Table1的5.31、0.966不同,按原表分别记录;没有误差条,不把微小差异说成显著提升。这里没有覆盖三角支撑、MLP、偏移和采样策略的完整因子消融。
成本与实现边界
主p.6 §5.1:本法训练包含4000步支撑优化和30000步细节优化;基线先30000步,抽稀后各LOD再5000步。本法各LOD额外精修和共享资产成本未交代同样清楚,不能声称同训练预算或零额外训练的即时切换。网络为两隐藏层64维,部分复杂场景128维。
主文未报告硬件、完整墙钟、FPS、峰值训练/渲染显存或真实VR部署;模型存储小不等于整个运行过程省显存。基线仅3DGS和Scaffold-GS,作者排除了HAC等压缩方法,不能据此证明强压缩基线已被超越。
官方页本次仅列主文PDF,没有补充或代码链接;作者主页同样未提供可核验的独立代码包。补充细节、完整split/分辨率及开源许可仍待核。未下载训练数据或进行GPU实验。
跨论文判断与可证伪下一步
与UVGS一样,应把资产存储、画质和学习成本分开;三角支撑进一步提供了可抽稀结构,但不等于有真实表面拓扑。与Matryoshka比较前,要统一输入、底座、总训练/精修预算及存储定义,再看相同字节下的PSNR、SSIM、LPIPS曲线。
若代码可得,先测整套分级资产的总字节、加载加MLP加渲染的总延迟和峰值显存。若等预算优势消失,或小存储依赖高额精修,就应缩小“适合资源受限设备”的结论。当前只支持本文数据范围内的质量—存储取舍,不直接支持几何、语义、移动部署或新颖性判断。
原始链接
相关页面
- 三维高斯泼溅:表示、优化、几何与动态任务:存储、显存、画质和完整运行成本分开验收。
- 原始3DGS:逐场景高斯优化与光栅化底座。
- Matryoshka:另一种按预算缩减的训练机制。